LLM autoalojado en un teléfono: el modelo 9B que Coinbase ajustó para superar a Opus
El 12 de octubre, el CEO de Coinbase, Brian Armstrong, publicó que sus ingenieros habían ajustado Qwen3.5-9B, un modelo gratuito de pesos abiertos, con datos internos, y que superaba a los modelos de frontera en la prevención del fraude. La publicación ya supera los 1,6 millones de visualizaciones. Con nueve mil millones de parámetros, el modelo es lo bastante pequeño para ser un LLM autoalojado del que una empresa es dueña por completo: Coinbase lo entrenó por menos de 100 dólares y lo sirve por su cuenta en lugar de llamar a la API de un proveedor.
También es lo bastante pequeño para un teléfono. Qwen3.5-9B se ejecuta en teléfonos Android de 16 GB de la red Acurast, detrás de una dirección HTTPS que ofrece la misma API que OpenAI, por unos 0,6 a 1 ACU por teléfono y día. Las mediciones de este artículo proceden de pruebas en la mainnet de Acurast, e incluyen cómo un mismo modelo escala a tantos teléfonos como requiera el trabajo.
Lo que construyó Coinbase
Coinbase Onramp permite comprar cripto dentro de aplicaciones asociadas, a veces como invitado y sin historial de cuenta. Para detectar el fraude ahí, Coinbase añadió un revisor basado en un LLM detrás de sus reglas existentes. Lee unos 7.000 tokens de contexto por transacción (un token es un fragmento de palabra, aproximadamente tres cuartos de una palabra) y responde con una sola línea, como RISK_LEVEL: 5.
El primer revisor fue Claude Opus. Cuando el propio benchmark de Coinbase mostró que las versiones más nuevas de Opus, Sonnet y GPT detectaban peor el fraude, el equipo entrenó en su lugar Qwen3.5-9B con los resultados históricos de sus casos de fraude. Usó LoRA, un método que entrena un pequeño conjunto de pesos adicionales en lugar del modelo completo. El resultado:
- Entrenamiento: una GPU de Nvidia, menos de 100 dólares.
- Calidad: mejor que el revisor con Opus 4.5 en las cuatro métricas de fraude, incluido un F1 9,6 puntos más alto, la puntuación que equilibra la detección de fraude con las falsas alarmas.
- Velocidad: una mediana de tiempo de respuesta inferior a la mitad de la del revisor con Opus 4.5.
«Los modelos de frontera son generalistas increíbles. Pero cada vez más verás modelos especializados que los superan en tareas más concretas, ya sea trabajando en equipo o por sí solos».
Brian Armstrong, CEO de Coinbase, en X
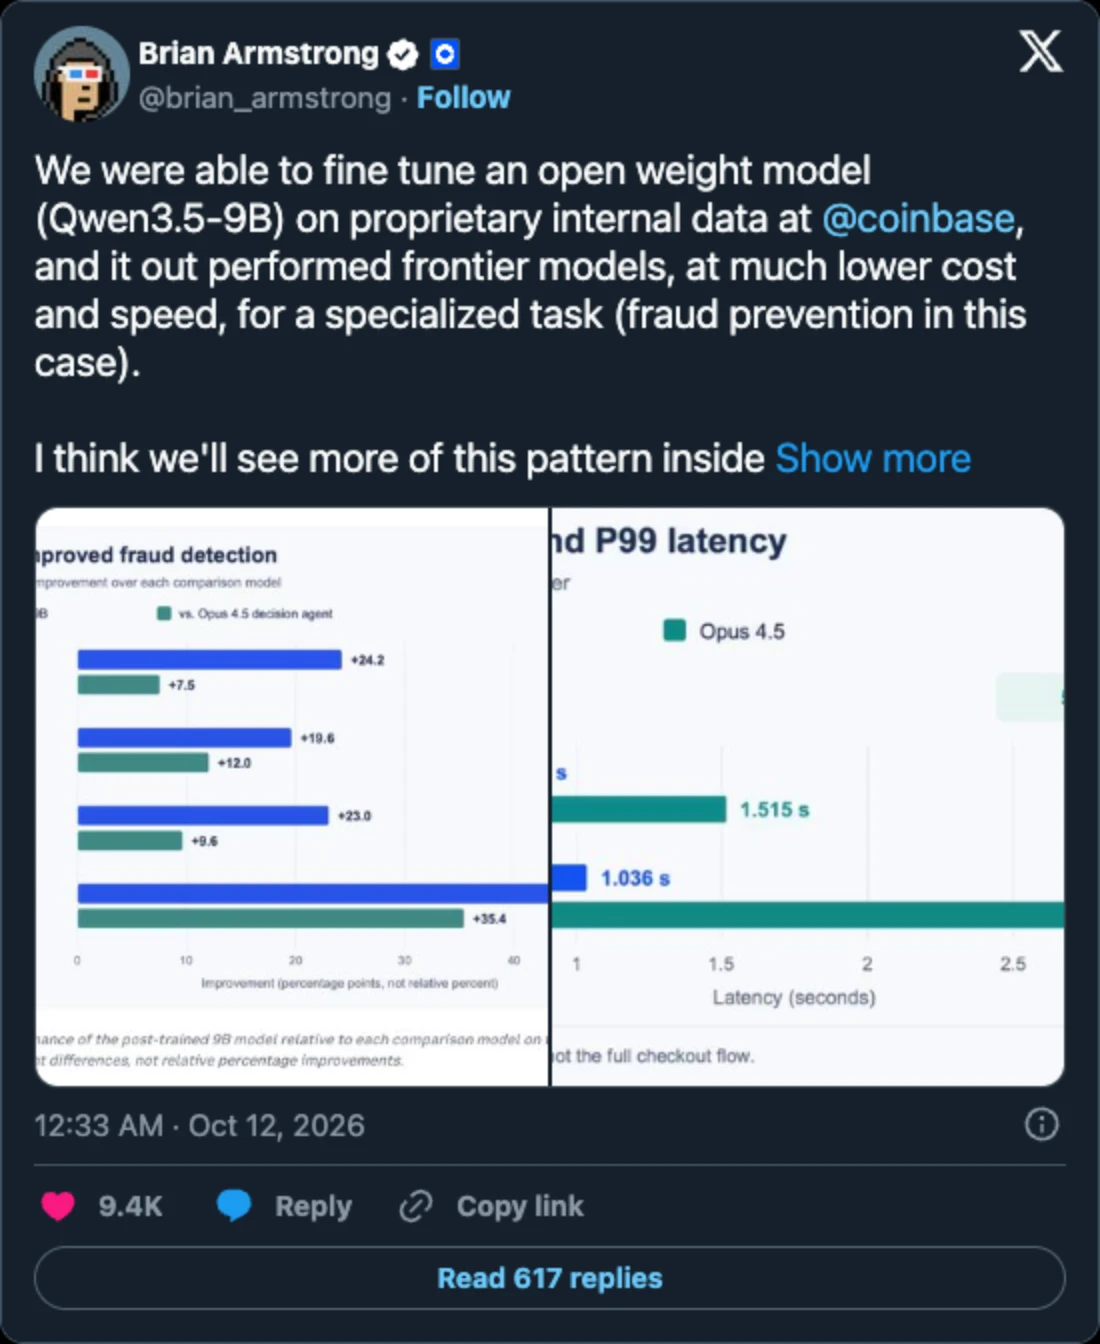
Armstrong prevé que algunos servicios de backend sean «sustituidos por completo por esta nueva arquitectura». Si eso ocurre, los equipos necesitarán un lugar donde ejecutar esos modelos especializados, y el entrenamiento es la parte barata: el de Coinbase costó menos de 100 dólares.
Un modelo 9B en un teléfono en cinco minutos
Comprimido a unos 4 bits por peso, Qwen3.5-9B es un archivo de 5,7 GB. Usa GGUF, el formato de llama.cpp, el motor de código abierto que ejecuta modelos de lenguaje en CPU convencionales. Un teléfono de gama alta con 16 GB de RAM lo carga con unos 0,8 GB de margen.
El entorno de ejecución Node.js de Acurast incluye llama.cpp, y el Acurast Tunnel da a un despliegue una dirección pública https://<id>.acu.run con un certificado real. La app de prueba, de menos de 300 líneas de JavaScript, abrió el túnel, descargó el modelo de Hugging Face, probó varias configuraciones del servidor, se quedó con la más rápida y sirvió una API compatible con OpenAI. Solo se ejecutó en teléfonos atestados. La primera respuesta llegó unos cinco minutos después del comando de despliegue. Sin GPU, sin cuenta en la nube, sin Docker.
Resultados del benchmark de Qwen 3.5 9B en teléfonos
Un LLM lee el prompt, algo rápido porque ocurre en paralelo, y después escribe la respuesta token a token. En los teléfonos más rápidos de las pruebas, teléfonos de la clase Snapdragon 8 Elite con MNN, Qwen3.5-9B leyó el prompt a una velocidad de hasta 85,2 tokens por segundo y escribió 9,3 tokens por segundo.
Los modelos más pequeños de la misma familia son mucho más rápidos, porque lo que limita a los teléfonos es la velocidad a la que mueven los pesos por la memoria. La animación reproduce en tiempo real una respuesta a la mayor velocidad de escritura medida para cada modelo.
El modelo 4B también funciona en teléfonos de 8 GB, así que muchos más Processors cumplen los requisitos. El modelo 0.8B deja la memoria casi sin usar, de modo que un teléfono puede atender varias conversaciones a la vez: incluso un teléfono de 8 GB atendió cuatro chats en paralelo a 46 tokens por segundo en conjunto.
Cuánto cuesta
Un despliegue fija un precio máximo en ACU, el token de utilidad de la red, y el Matcher lo empareja con teléfonos que cumplen sus requisitos. Para teléfonos con 12 GB de RAM o más, la media del mercado el día de la prueba fue de 0,57 ACU por teléfono y día, y con 1,03 ACU el emparejamiento era inmediato. Eso equivalía a unos 5 a 10 centavos de dólar en ese momento. Todo el estudio, unas 60 ejecuciones en teléfonos, costó unos 14 ACU.
Muchas solicitudes a la vez
Una prueba más amplia alquiló más de 100 teléfonos y cronometró un prompt real de 7.000 tokens, el tamaño que lee el revisor de Coinbase. El más rápido fue un teléfono de 16 GB con un chip de la clase Snapdragon 8 Elite que ejecutaba MNN, un motor de código abierto de Alibaba, la empresa que desarrolla Qwen. Leyó el prompt en 3 minutos y 15 segundos con el modelo 9B, en 1 minuto y 37 segundos con el 4B y en 15 segundos con el 0.8B.
Tiempo que tarda un teléfono en leer un prompt de 7.000 tokens
Qwen3.5-9B
3 min 15 s
Qwen3.5-4B
1 min 37 s
Qwen3.5-0.8B
15 s
Medido con un prompt real de 7.000 tokens en el teléfono más rápido de una prueba con 100 teléfonos (16 GB, chip de la clase Snapdragon 8 Elite), motor MNN, 8 hilos de CPU, modelos de 4 bits.
Esos tiempos corresponden a una solicitud en un teléfono. Cada teléfono procesa sus propias solicitudes, así que diez réplicas leen diez prompts a la vez y cien leen cien. Para una cola de revisión o un lote nocturno, la cifra que cuenta es cuánto trabajo se completa por hora, y crece con cada teléfono que se añade.
Dónde encaja un modelo especializado alojado en un teléfono
La mayor parte del trabajo especializado se ejecuta en colas y en segundo plano, donde el volumen de procesamiento y la disponibilidad cuentan más que la velocidad de una sola respuesta:
- Colas de segunda revisión: los contracargos, las cuentas marcadas y los tickets de soporte reciben un primer veredicto en menos de un minuto en lugar de esperar horas a una persona.
- Guardianes siempre activos: filtros de estafas para chats de comunidades y controles de inyección de prompts delante de agentes de IA, que leen mensajes cortos en segundos.
- Evaluación por lotes: volver a revisar durante la noche las transacciones del día anterior, repartidas entre tantos teléfonos como necesite el trabajo.
Las demos de Laya muestran el extremo de las entradas cortas: un clasificador en un solo teléfono que filtra mensajes de estafa en 0,2 a 1 segundo.
Lo que aporta la red: privacidad, escala y disponibilidad
Privacidad. Los prompts van a tu propio despliegue, no a un proveedor de modelos, que es el motivo que dio Coinbase para alojar su propio modelo. Según la documentación de Acurast, los entornos de ejecución de confianza (TEE) de los smartphones «confirman que el hardware es auténtico y no falso, y mantienen la confidencialidad sin necesidad de confiar en el propietario del teléfono». Los secretos, como la clave de API, viajan como variables de entorno cifradas, que «solo se descifran cuando el código se ejecuta en un Processor».
Escala. Una sola configuración puso en marcha diez teléfonos, cada uno con su propia dirección HTTPS fija, y una prueba más amplia alquiló más de 100 en una tarde. Añadir capacidad consiste en aumentar el número de réplicas: 137 teléfonos cumplían los requisitos del modelo 0.8B, así que la misma configuración con 100 réplicas ya es viable hoy.
Disponibilidad. Un despliegue repartido entre teléfonos en muchos lugares no depende de un único centro de datos que pueda caerse. Las réplicas de reserva mantienen la cola en marcha cuando un teléfono está ocupado o desconectado, y la misma configuración puede volver a desplegarse en teléfonos nuevos en cualquier momento.
Ejecuta tu propio modelo
El código de este artículo es abierto. El ejemplo de Qwen de las apps de muestra de Acurast ejecuta Qwen3.5 en un teléfono detrás de una API compatible con OpenAI y se abre en el playground del Acurast Hub sin paso de compilación. Un segundo ejemplo, LLM on MNN, sirve la misma API con el motor MNN, el que está detrás de las cifras más rápidas de este artículo, y también está en el playground. La guía de LLM de la documentación de Acurast explica cómo cargar un modelo en un despliegue, y la guía de inicio rápido de Acurast Tunnel cubre la dirección HTTPS pública. Si ajustas un modelo como hizo Coinbase, fusiona los pesos LoRA con el modelo antes de convertirlo: el resultado tiene el mismo tamaño y la misma velocidad que el modelo base.
¿Construyes sobre Acurast? Si entrenas tus propios modelos especializados y quieres servirlos en teléfonos atestados, ven a intercambiar experiencias en el Discord de Acurast.