Selbst gehostetes LLM auf dem Smartphone: Das 9B-Modell, mit dem Coinbase per Fine-Tuning Opus schlägt
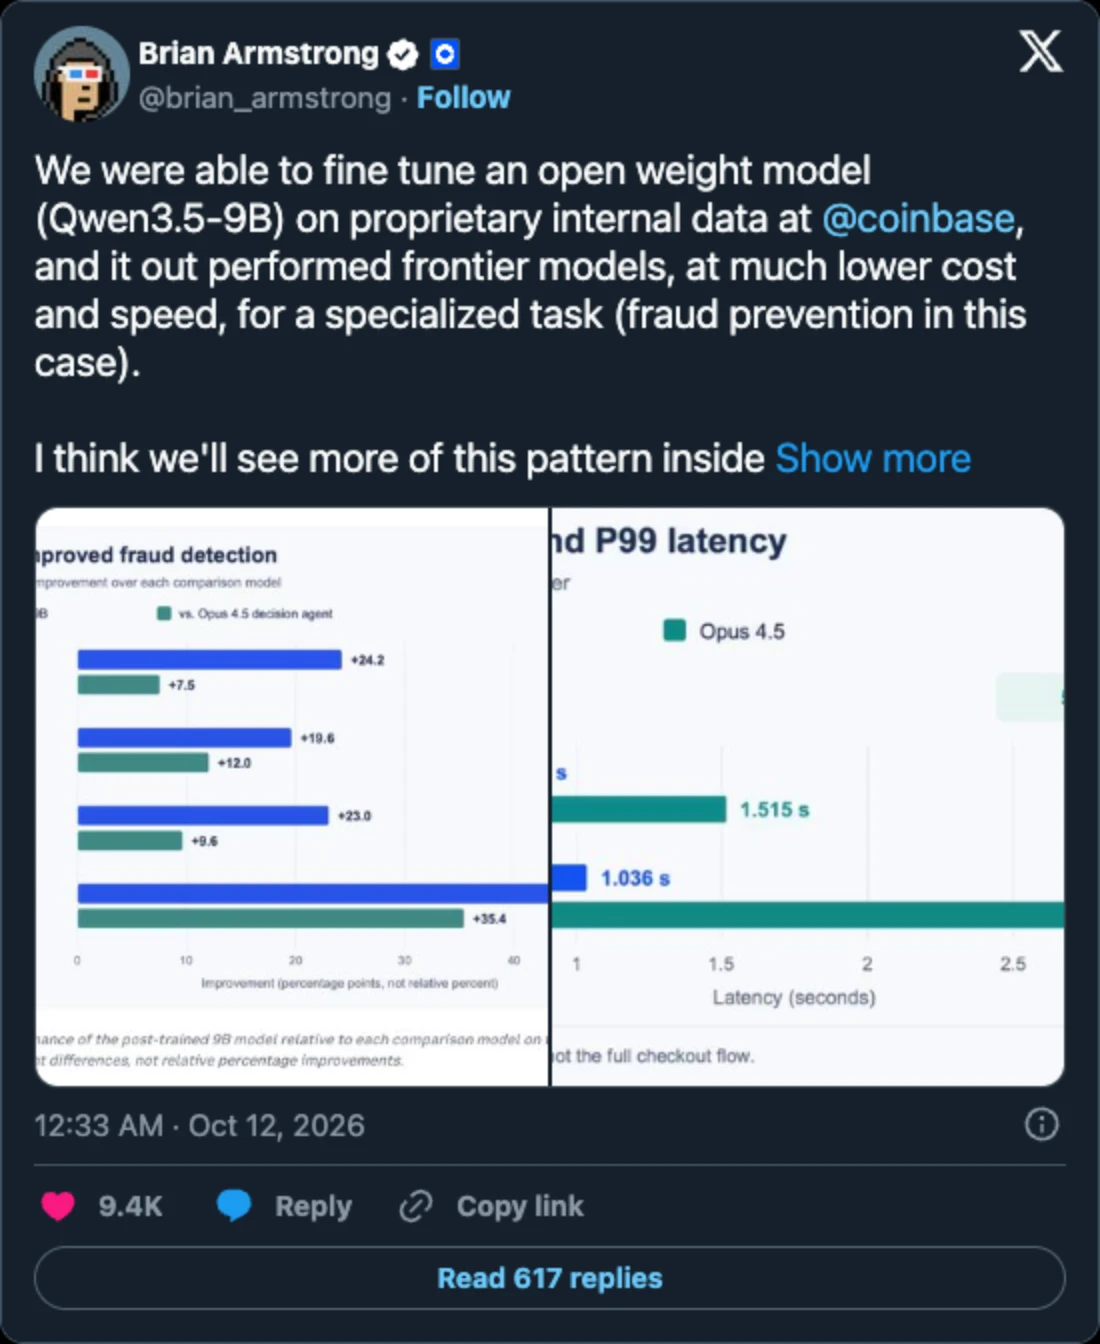
Am 12. Oktober schrieb Coinbase-CEO Brian Armstrong, seine Ingenieure hätten Qwen3.5-9B, ein kostenloses Modell mit offenen Gewichten, per Fine-Tuning mit internen Daten angepasst, und es schlage Frontier-Modelle bei der Betrugsprävention. Der Beitrag hat inzwischen mehr als 1,6 Millionen Aufrufe. Mit neun Milliarden Parametern ist es klein genug für ein selbst gehostetes LLM, das einem Unternehmen vollständig gehört: Coinbase hat es für weniger als 100 US-Dollar trainiert und betreibt es selbst, statt die API eines Anbieters aufzurufen.
Es ist auch klein genug für ein Smartphone. Qwen3.5-9B läuft im Acurast-Netzwerk auf Android-Smartphones mit 16 GB, hinter einer HTTPS-Adresse, die dieselbe API spricht wie OpenAI, für etwa 0,6 bis 1 ACU pro Smartphone und Tag. Die Messwerte hier stammen aus Tests im Acurast-Mainnet, darunter auch, wie ein Modell auf so viele Smartphones skaliert, wie es die Arbeit erfordert.
Was Coinbase gebaut hat
Mit Coinbase Onramp können Menschen Kryptowährungen in Partner-Apps kaufen, manchmal als Gast ohne Kontohistorie. Um dort Betrug zu erkennen, hat Coinbase seinen bestehenden Regeln einen LLM-Prüfer nachgeschaltet. Er liest pro Transaktion etwa 7.000 Tokens Kontext (ein Token ist ein Wortfragment, ungefähr drei Viertel eines Wortes) und antwortet mit einer einzigen Zeile, etwa RISK_LEVEL: 5.
Der erste Prüfer war Claude Opus. Als der eigene Benchmark von Coinbase zeigte, dass neuere Versionen von Opus, Sonnet und GPT Betrug schlechter erkannten, trainierte das Team stattdessen Qwen3.5-9B mit dem tatsächlichen Ausgang früherer Betrugsfälle. Dafür nutzte es LoRA, eine Methode, die statt des ganzen Modells nur einen kleinen Satz zusätzlicher Gewichte trainiert. Das Ergebnis:
- Training: eine Nvidia-GPU, weniger als 100 US-Dollar.
- Qualität: besser als der Prüfer mit Opus 4.5 bei allen vier Betrugsmetriken, darunter ein um 9,6 Punkte höherer F1-Wert, die Kennzahl, die das Erkennen von Betrug gegen Fehlalarme abwägt.
- Geschwindigkeit: im Median eine Antwort in weniger als der Hälfte der Zeit, die der Prüfer mit Opus 4.5 brauchte.
„Die Frontier-Modelle sind großartige Generalisten. Doch man wird immer öfter sehen, dass Spezialmodelle bei enger gefassten Aufgaben besser abschneiden, ob im Team oder allein.“
Brian Armstrong, CEO von Coinbase, auf X
Armstrong erwartet, dass manche Backend-Dienste „vollständig durch diese neue Architektur ersetzt“ werden. Wenn es so kommt, brauchen Teams einen Ort, an dem diese Spezialmodelle laufen, und das Training ist der günstige Teil: Der Trainingslauf von Coinbase kostete weniger als 100 US-Dollar.
Ein 9B-Modell in fünf Minuten auf dem Smartphone
Auf etwa 4 Bit pro Gewicht komprimiert, ist Qwen3.5-9B eine 5,7 GB große Datei. Sie nutzt GGUF, das Format von llama.cpp, der Open-Source-Engine, die Sprachmodelle auf gewöhnlichen CPUs ausführt. Ein Flaggschiff-Smartphone mit 16 GB RAM fasst sie und hat dann noch etwa 0,8 GB frei.
Die Node.js-Laufzeitumgebung von Acurast bringt llama.cpp bereits mit, und der Acurast Tunnel gibt einem Deployment eine öffentliche Adresse https://<id>.acu.run mit echtem Zertifikat. Die Test-App, weniger als 300 Zeilen JavaScript, öffnete den Tunnel, lud das Modell von Hugging Face herunter, verglich einige Servereinstellungen per Benchmark, behielt die schnellste und stellte eine OpenAI-kompatible API bereit. Sie lief ausschließlich auf attestierten Smartphones. Die erste Antwort kam etwa fünf Minuten nach dem Deploy-Befehl. Keine GPU, kein Cloud-Konto, kein Docker.
Benchmark-Ergebnisse von Qwen 3.5 9B auf Smartphones
Ein LLM liest zuerst den Prompt, was schnell geht, weil es parallel geschieht, und schreibt dann die Antwort Token für Token. Auf den schnellsten Smartphones in den Tests, solchen mit einem Chip der Klasse Snapdragon 8 Elite, auf denen MNN lief, las Qwen3.5-9B den Prompt mit bis zu 85,2 Tokens pro Sekunde und schrieb 9,3 Tokens pro Sekunde.
Kleinere Modelle derselben Familie sind deutlich schneller, denn Smartphones sind dadurch begrenzt, wie schnell sie Gewichte durch den Speicher bewegen. Die Animation spielt eine Antwort in Echtzeit mit der schnellsten Schreibgeschwindigkeit ab, die für jedes Modell gemessen wurde.
Das 4B-Modell läuft auch auf Smartphones mit 8 GB, sodass weit mehr Processors infrage kommen. Das 0.8B-Modell lässt den Speicher größtenteils ungenutzt, sodass ein Smartphone mehrere Unterhaltungen gleichzeitig bedienen kann: Selbst ein Smartphone mit 8 GB bediente vier parallele Chats mit zusammen 46 Tokens pro Sekunde.
Was es kostet
Ein Deployment legt einen Höchstpreis in ACU fest, dem Utility-Token des Netzwerks, und der Matcher bringt es mit Smartphones zusammen, die seine Anforderungen erfüllen. Für Smartphones mit 12 GB RAM oder mehr lag der Marktdurchschnitt am Testtag bei 0,57 ACU pro Smartphone und Tag, und für 1,03 ACU gab es sofortiges Matching. Das waren damals etwa 5 bis 10 US-Cent. Die gesamte Studie mit rund 60 Smartphone-Läufen kostete etwa 14 ACU.
Viele Anfragen gleichzeitig
Ein größerer Test mietete mehr als 100 Smartphones und stoppte die Zeit für einen echten Prompt mit 7.000 Tokens, so lang wie die Eingaben, die der Coinbase-Prüfer liest. Am schnellsten war ein Smartphone mit 16 GB und einem Chip der Klasse Snapdragon 8 Elite, auf dem MNN lief, eine Open-Source-Engine von Alibaba, dem Entwickler von Qwen. Es las den Prompt mit dem 9B-Modell in 3 Minuten 15 Sekunden, mit 4B in 1 Minute 37 Sekunden und mit 0.8B in 15 Sekunden.
Lesezeit eines Smartphones für einen Prompt mit 7.000 Tokens
Qwen3.5-9B
3 Min. 15 s
Qwen3.5-4B
1 Min. 37 s
Qwen3.5-0.8B
15 s
Gemessen anhand eines echten Prompts mit 7.000 Tokens auf dem schnellsten Smartphone eines Tests mit 100 Smartphones (16 GB, Chip der Klasse Snapdragon 8 Elite), MNN-Engine, 8 CPU-Threads, 4-Bit-Modelle.
Diese Zeiten gelten für eine Anfrage auf einem Smartphone. Jedes Smartphone arbeitet seine eigenen Anfragen ab, sodass zehn Replikate zehn Prompts gleichzeitig lesen und hundert Replikate hundert. Für eine Prüfwarteschlange oder einen nächtlichen Batch zählt, wie viel pro Stunde erledigt wird, und dieser Wert wächst mit jedem zusätzlichen Smartphone.
Wofür sich ein Spezialmodell auf Smartphones eignet
Die meiste Arbeit von Spezialmodellen läuft in Warteschlangen und im Hintergrund, wo Durchsatz und Verfügbarkeit mehr zählen als die Geschwindigkeit einer einzelnen Antwort:
- Warteschlangen zur Zweitprüfung: Rückbuchungen, markierte Konten und Support-Tickets erhalten innerhalb einer Minute eine erste Einschätzung, statt stundenlang auf einen Menschen zu warten.
- Wächter im Dauerbetrieb: Betrugsfilter für Community-Chats und Prompt-Injection-Prüfungen vor KI-Agenten lesen kurze Nachrichten in Sekunden.
- Batch-Bewertung: die Transaktionen von gestern über Nacht erneut prüfen, verteilt auf so viele Smartphones, wie die Aufgabe braucht.
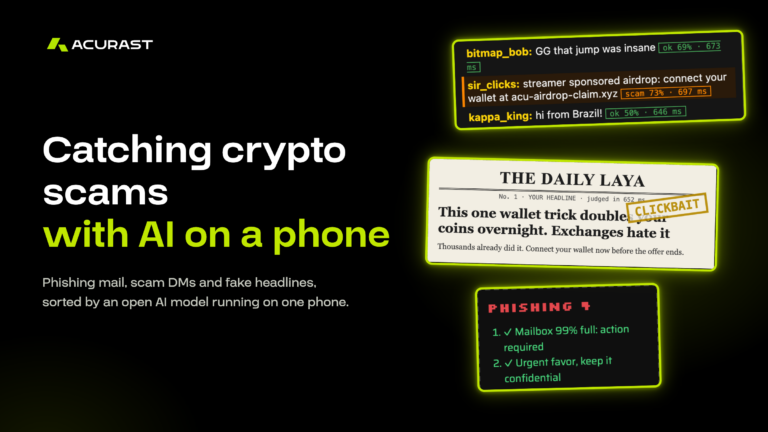
Die Laya-Demos zeigen das Szenario mit kurzen Eingaben: Ein Klassifikator auf einem einzigen Smartphone sortiert Betrugsnachrichten in 0,2 bis 1 Sekunde.
Was das Netzwerk beiträgt: Privatsphäre, Skalierung und Verfügbarkeit
Privatsphäre. Prompts gehen an Ihr eigenes Deployment, nicht an einen Modellanbieter, und genau das nannte Coinbase als Grund für das Selbsthosten. Trusted Execution Environments (TEEs) in Smartphones „bestätigen, dass Hardware echt und nicht gefälscht ist, und wahren die Vertraulichkeit, ohne dass man dem Besitzer des Smartphones vertrauen muss“, so die Acurast-Dokumentation. Secrets wie der API-Schlüssel werden als verschlüsselte Umgebungsvariablen übertragen, „die erst entschlüsselt werden, wenn der Code auf einem Processor läuft“.
Skalierung. Eine einzige Konfiguration betrieb zehn Smartphones, jedes mit seiner eigenen festen HTTPS-Adresse, und ein größerer Test mietete an einem Nachmittag mehr als 100. Mehr Kapazität heißt: die Anzahl der Replikate erhöhen. 137 Smartphones erfüllten die Anforderungen des 0.8B-Modells, dieselbe Konfiguration mit 100 Replikaten passt also schon heute.
Verfügbarkeit. Ein Deployment, das über Smartphones an vielen Orten verteilt ist, hat kein einzelnes Rechenzentrum, das ausfallen kann. Zusätzliche Replikate halten eine Warteschlange in Bewegung, wann immer ein Smartphone ausgelastet oder offline ist, und dieselbe Konfiguration lässt sich jederzeit auf neue Smartphones erneut deployen.
Ihr eigenes Modell betreiben
Der Code hinter diesem Beitrag ist offen. Das Qwen-Beispiel in den Acurast Example Apps führt Qwen3.5 auf einem Smartphone hinter einer OpenAI-kompatiblen API aus und lässt sich ohne Build-Schritt im Playground von Acurast Hub öffnen. Ein zweites Beispiel, LLM on MNN, stellt dieselbe API mit der MNN-Engine bereit, die hinter den schnellsten Werten in diesem Beitrag steckt, und ist ebenfalls im Playground verfügbar. Der LLM-Leitfaden in der Acurast-Dokumentation erklärt, wie Sie ein Modell in einem Deployment laden, und der Quickstart zum Acurast Tunnel behandelt die öffentliche HTTPS-Adresse. Wenn Sie ein Modell wie Coinbase per Fine-Tuning anpassen, mergen Sie die LoRA-Gewichte vor der Konvertierung in das Modell: Das Ergebnis hat dieselbe Größe und Geschwindigkeit wie das Basismodell.
Sie bauen auf Acurast? Wenn Sie eigene Spezialmodelle trainieren und sie auf attestierten Smartphones bereitstellen möchten, tauschen Sie sich im Acurast Discord mit anderen aus.