휴대폰에서 실행하는 셀프 호스팅 LLM: Coinbase가 Opus를 넘어서도록 파인튜닝한 9B 모델
10월 12일, Coinbase CEO Brian Armstrong은 자사 엔지니어들이 무료 오픈 웨이트 모델인 Qwen3.5-9B를 내부 데이터로 파인튜닝했으며, 이 모델이 사기 방지에서 프런티어 모델들을 앞섰다고 밝혔습니다. 이 게시물의 조회수는 160만회를 넘었습니다. 파라미터 90억 개라면 기업이 온전히 소유하는 셀프 호스팅 LLM으로 쓰기에 충분히 작습니다. Coinbase는 이 모델을 100달러 미만의 비용으로 학습시켰고, 외부 업체의 API를 호출하는 대신 직접 서빙합니다.
휴대폰에 올리기에도 충분히 작습니다. Qwen3.5-9B는 Acurast 네트워크의 16 GB Android 휴대폰에서 OpenAI와 같은 API를 제공하는 HTTPS 주소 뒤에서 실행되며, 비용은 휴대폰 한 대당 하루 약 0.6~1 ACU입니다. 이 글의 측정값은 Acurast 메인넷에서 진행한 테스트에서 나왔으며, 하나의 모델을 작업에 필요한 만큼 많은 휴대폰으로 확장하는 과정도 포함합니다.
Coinbase가 만든 것
Coinbase Onramp를 사용하면 파트너 앱 안에서 암호화폐를 구매할 수 있으며, 계정 이력이 없는 게스트로 구매하는 경우도 있습니다. 이곳에서 사기를 잡기 위해 Coinbase는 기존 규칙 뒤에 LLM 리뷰어를 추가했습니다. 이 리뷰어는 거래 한 건당 약 7,000토큰의 컨텍스트를 읽고(토큰은 단어 조각으로, 대략 단어 하나의 4분의 3 정도입니다) RISK_LEVEL: 5 같은 한 줄로 답합니다.
첫 번째 리뷰어는 Claude Opus였습니다. Coinbase 자체 벤치마크에서 더 새로운 Opus, Sonnet, GPT 버전의 사기 탐지 점수가 오히려 낮게 나오자, 팀은 대신 과거 사기 판정 결과로 Qwen3.5-9B를 학습시켰습니다. 이때 사용한 LoRA는 모델 전체가 아니라 소량의 추가 가중치만 학습시키는 방법입니다. 결과는 다음과 같습니다.
- 학습: Nvidia GPU 1개, 100달러 미만.
- 품질: 네 가지 사기 지표 모두에서 Opus 4.5 리뷰어보다 뛰어났으며, 특히 사기 탐지와 오탐 사이의 균형을 나타내는 점수인 F1이 9.6포인트 높았습니다.
- 속도: 응답 시간 중앙값이 Opus 4.5 리뷰어의 절반에도 못 미쳤습니다.
“프런티어 모델은 놀라운 제너럴리스트입니다. 하지만 앞으로는 팀의 일원으로든 단독으로든, 더 좁은 작업에서 전문 모델이 더 뛰어난 성능을 내는 경우를 점점 더 많이 보게 될 것입니다.”
Brian Armstrong, Coinbase CEO, X에서
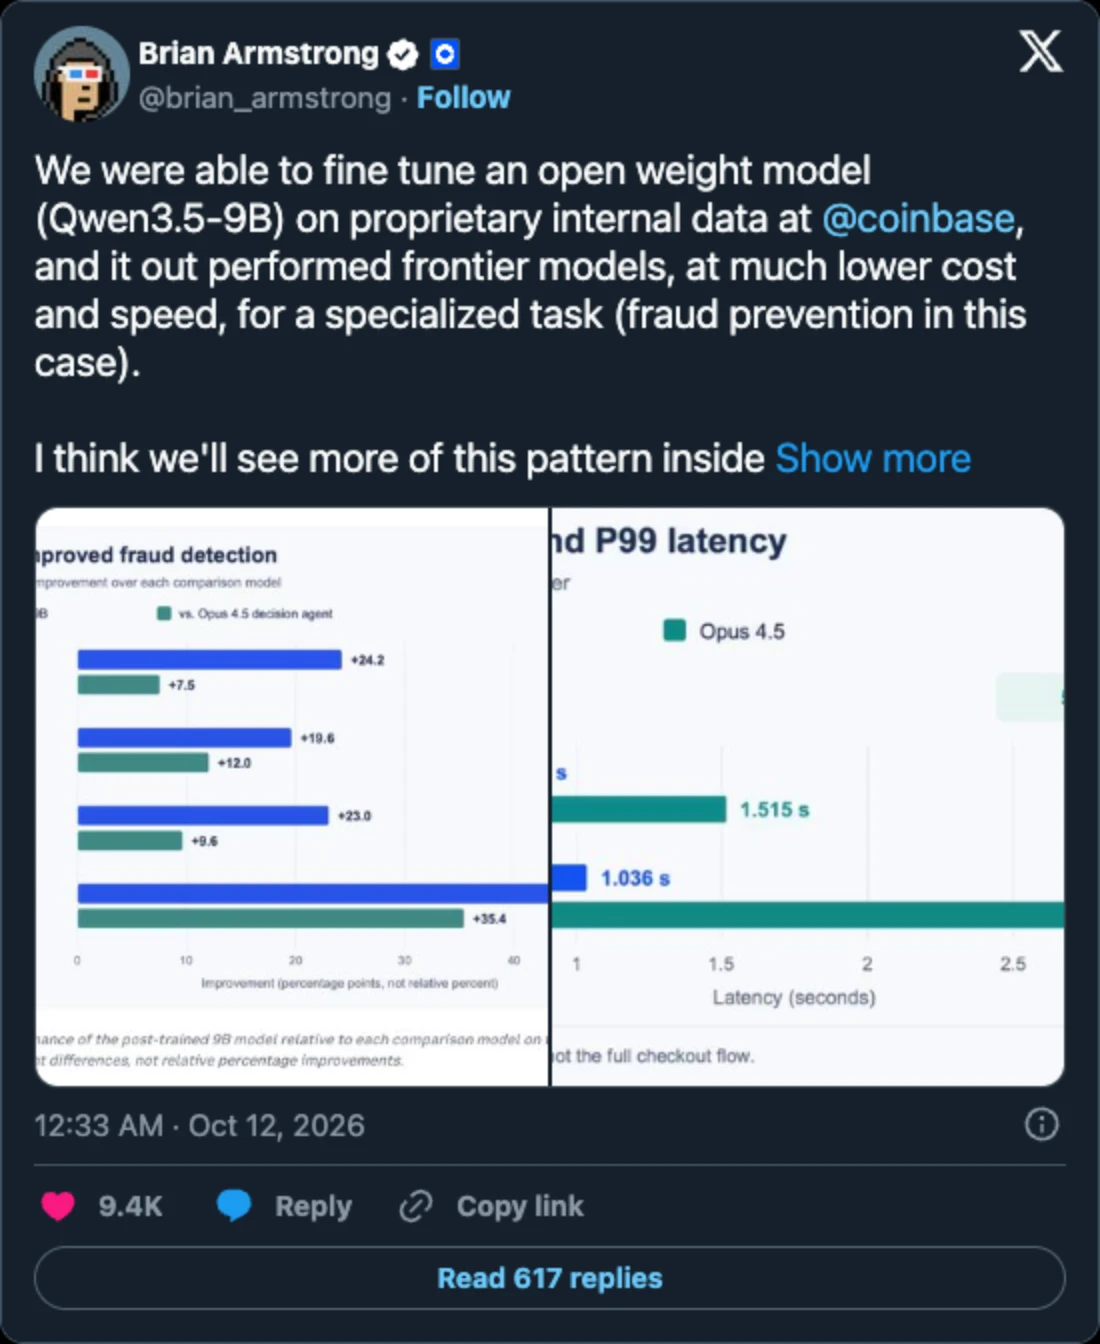
Armstrong은 일부 백엔드 서비스가 “이 새로운 아키텍처로 완전히 대체될” 것으로 내다봅니다. 그렇게 되면 팀들에게는 이런 전문 모델을 실행할 곳이 필요해지며, 학습은 비용이 적게 드는 부분입니다. Coinbase의 학습에는 100달러도 들지 않았습니다.
5분 만에 휴대폰에서 실행하는 9B 모델
가중치당 약 4비트로 압축하면 Qwen3.5-9B는 5.7 GB 파일이 됩니다. 형식은 GGUF로, 일반 CPU에서 언어 모델을 실행하는 오픈 소스 엔진 llama.cpp의 형식입니다. RAM이 16 GB인 플래그십 휴대폰에 올려도 약 0.8 GB의 여유가 남습니다.
Acurast의 Node.js 런타임에는 llama.cpp가 기본 내장되어 있으며, Acurast Tunnel은 배포에 실제 인증서가 적용된 공개 https://<id>.acu.run 주소를 제공합니다. 300줄이 안 되는 JavaScript로 작성된 테스트 앱은 터널을 열고, Hugging Face에서 모델을 내려받고, 몇 가지 서버 설정을 벤치마크해 가장 빠른 설정을 남긴 뒤 OpenAI 호환 API를 제공했습니다. 앱은 증명된 휴대폰에서만 실행되었습니다. 첫 응답은 배포 명령을 실행한 지 약 5분 만에 도착했습니다. GPU도, 클라우드 계정도, Docker도 필요 없었습니다.
휴대폰에서 측정한 Qwen 3.5 9B 벤치마크 결과
LLM은 먼저 프롬프트를 읽는데, 이 과정은 병렬로 처리되므로 빠릅니다. 그다음 답을 한 번에 한 토큰씩 씁니다. 테스트에서 가장 빨랐던 휴대폰, 즉 MNN을 실행한 Snapdragon 8 Elite급 휴대폰에서 Qwen3.5-9B는 프롬프트를 초당 최대 85.2토큰으로 읽고 초당 9.3토큰을 썼습니다.
같은 계열의 더 작은 모델은 훨씬 빠릅니다. 휴대폰의 속도는 메모리에서 가중치를 얼마나 빨리 옮기느냐에 따라 정해지기 때문입니다. 아래 애니메이션은 모델별로 측정한 가장 빠른 쓰기 속도로 하나의 답변을 실시간으로 재생합니다.
4B 모델은 8 GB 휴대폰에서도 실행되므로 조건을 충족하는 프로세서가 훨씬 많습니다. 0.8B 모델은 메모리를 대부분 비워 두기 때문에 휴대폰 한 대가 여러 대화를 동시에 처리할 수 있습니다. 8 GB 휴대폰조차 병렬 채팅 4개를 합계 초당 46토큰으로 처리했습니다.
실행 비용
배포는 네트워크의 유틸리티 토큰인 ACU로 최대 가격을 정하고, 매처(Matcher)는 요구 사항을 충족하는 휴대폰과 배포를 연결합니다. RAM이 12 GB 이상인 휴대폰의 경우 테스트 당일 시장 평균은 휴대폰 한 대당 하루 0.57 ACU였고, 1.03 ACU면 즉시 매칭되었습니다. 당시 기준으로 미화 약 5~10센트였습니다. 휴대폰 실행 약 60회로 이루어진 전체 테스트에 든 비용은 약 14 ACU였습니다.
여러 요청을 한 번에
더 큰 규모의 테스트에서는 휴대폰 100대 이상을 빌려, Coinbase 리뷰어가 읽는 것과 같은 크기인 실제 7,000토큰 프롬프트의 처리 시간을 측정했습니다. 가장 빠른 휴대폰은 Snapdragon 8 Elite급 칩을 탑재한 16 GB 휴대폰으로, Qwen 개발사인 Alibaba의 오픈 소스 엔진 MNN을 실행했습니다. 이 휴대폰은 9B 모델로 3분 15초, 4B로 1분 37초, 0.8B로 15초 만에 프롬프트를 읽었습니다.
휴대폰 한 대가 7,000토큰 프롬프트를 읽는 시간
Qwen3.5-9B
3분 15초
Qwen3.5-4B
1분 37초
Qwen3.5-0.8B
15초
휴대폰 100대 테스트에서 가장 빠른 휴대폰(16 GB, Snapdragon 8 Elite급 칩)으로 실제 7,000토큰 프롬프트를 측정했습니다. MNN 엔진, CPU 스레드 8개, 4비트 모델 기준입니다.
이 시간은 휴대폰 한 대에서 요청 하나를 처리한 기준입니다. 휴대폰마다 각자의 요청을 처리하므로, 레플리카 10개는 프롬프트 10개를, 레플리카 100개는 프롬프트 100개를 동시에 읽습니다. 검토 대기열이나 야간 배치 작업에서 중요한 숫자는 시간당 처리량이며, 이 수치는 휴대폰을 추가할 때마다 늘어납니다.
휴대폰에서 호스팅하는 전문 모델이 적합한 곳
대부분의 전문 작업은 대기열과 백그라운드에서 실행되며, 이런 환경에서는 개별 응답 속도보다 처리량과 가용성이 더 중요합니다.
- 2차 검토 대기열: 차지백, 플래그가 지정된 계정, 고객 지원 티켓이 사람을 몇 시간씩 기다리는 대신 1분 안에 첫 판정을 받습니다.
- 상시 가동 가드: 커뮤니티 채팅용 사기 필터와 AI 에이전트 앞단의 프롬프트 인젝션 검사로, 짧은 메시지를 몇 초 만에 읽습니다.
- 배치 점수 산정: 전날의 거래를 밤사이 다시 검사하며, 작업에 필요한 만큼 많은 휴대폰에 분산합니다.
Laya 데모는 이 가운데 입력이 짧은 쪽을 보여 줍니다. 휴대폰 한 대의 분류기가 사기 메시지를 분류하는 데 0.2~1초가 걸립니다.
네트워크가 더하는 것: 프라이버시, 확장성, 가용성
프라이버시. 프롬프트는 모델 업체가 아니라 직접 운영하는 배포로 전달되며, 이는 Coinbase가 셀프 호스팅의 이유로 든 바로 그 점입니다. Acurast 문서에 따르면 스마트폰의 신뢰 실행 환경(TEE)은 “하드웨어가 가짜가 아닌 진품임을 확인하고, 하드웨어 소유자를 신뢰할 필요 없이 기밀성을 유지”합니다. API 키 같은 비밀 정보는 암호화된 환경 변수로 전달되며, “코드가 프로세서에서 실행될 때만 복호화”됩니다.
확장성. 설정 하나로 휴대폰 10대를 실행했고 각 휴대폰에는 고정된 HTTPS 주소가 따로 있었으며, 더 큰 규모의 테스트에서는 오후 한나절 만에 100대 이상을 빌렸습니다. 용량을 늘리려면 레플리카 수만 올리면 됩니다. 0.8B 모델의 요구 사항을 충족한 휴대폰은 137대였으므로, 같은 설정을 레플리카 100개로 실행하는 것도 지금 바로 가능합니다.
가용성. 여러 지역의 휴대폰에 분산된 배포에는 다운될 단일 데이터 센터가 없습니다. 휴대폰이 사용 중이거나 오프라인일 때도 여분의 레플리카가 대기열을 계속 처리하며, 같은 설정을 언제든 새 휴대폰에 다시 배포할 수 있습니다.
직접 실행해 보세요
이 글에 쓰인 코드는 공개되어 있습니다. Acurast 예제 앱의 Qwen 샘플은 OpenAI 호환 API 뒤에서 휴대폰으로 Qwen3.5를 실행하며, 빌드 단계 없이 Acurast Hub 플레이그라운드에서 바로 열립니다. 두 번째 샘플인 LLM on MNN은 이 글에서 가장 빠른 수치를 낸 MNN 엔진으로 같은 API를 제공하며, 이 샘플도 플레이그라운드에 있습니다. Acurast 문서의 LLM 가이드는 배포에서 모델을 로드하는 방법을 설명하고, Acurast Tunnel 빠른 시작 가이드는 공개 HTTPS 주소를 다룹니다. Coinbase처럼 파인튜닝한다면 변환하기 전에 LoRA 가중치를 모델에 병합하세요. 그러면 결과물의 크기와 속도가 기본 모델과 같습니다.
Acurast로 개발하고 계신가요? 직접 전문 모델을 학습시키고 있고 이를 증명된 휴대폰에서 서빙하고 싶으시다면, Acurast Discord에서 함께 경험을 나눠 보세요.