LLM self-hosted su smartphone: il modello 9B che Coinbase ha affinato per battere Opus
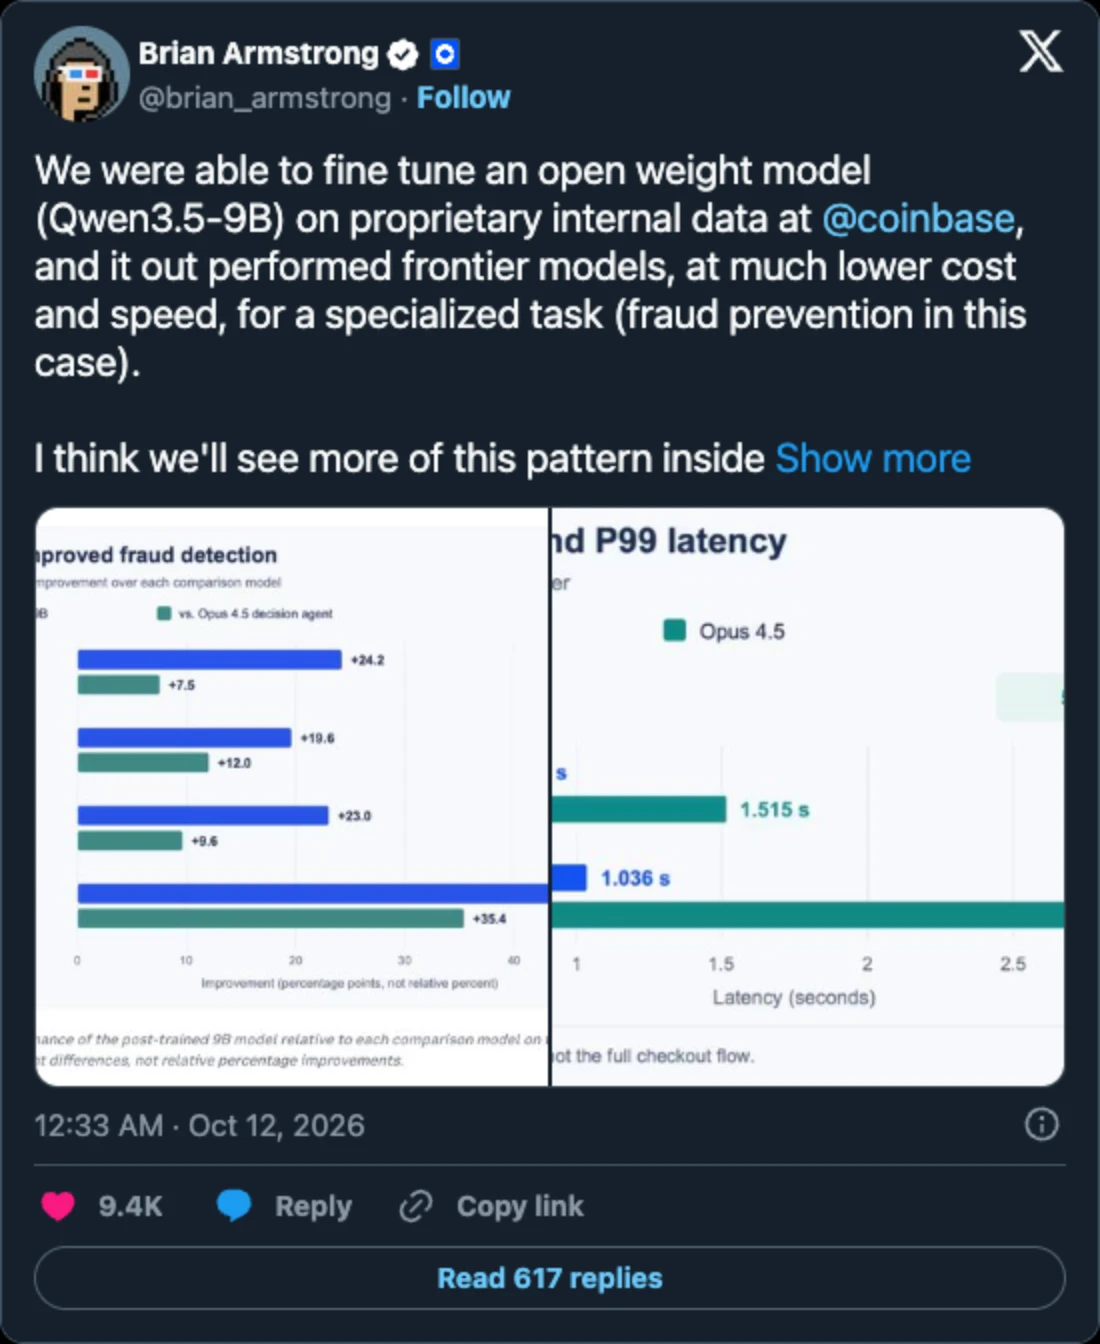
Il 12 ottobre Brian Armstrong, CEO di Coinbase, ha scritto che i suoi ingegneri avevano affinato Qwen3.5-9B, un modello gratuito a pesi aperti, su dati interni, e che nella prevenzione delle frodi superava i modelli di frontiera. Il post ha superato 1,6 milioni di visualizzazioni. Con nove miliardi di parametri, il modello è abbastanza piccolo da diventare un LLM self-hosted di cui un’azienda è interamente proprietaria: Coinbase lo ha addestrato con meno di 100 dollari e lo serve in proprio, invece di chiamare l’API di un fornitore.
È anche abbastanza piccolo per uno smartphone. Qwen3.5-9B gira sugli smartphone Android da 16 GB della rete Acurast, dietro un indirizzo HTTPS che espone la stessa API di OpenAI, al costo di circa 0,6-1 ACU per smartphone al giorno. Le misurazioni riportate qui vengono da test sulla mainnet di Acurast, compreso il modo in cui un modello scala su tutti gli smartphone di cui il lavoro ha bisogno.
Cosa ha costruito Coinbase
Coinbase Onramp permette di acquistare criptovalute all’interno delle app partner, a volte come ospite, senza alcuno storico dell’account. Per intercettare le frodi in questo contesto, Coinbase ha aggiunto un revisore basato su LLM a valle delle regole già in uso. Il revisore legge circa 7.000 token di contesto per transazione (un token è un frammento di parola, circa tre quarti di una parola) e risponde con una sola riga, ad esempio RISK_LEVEL: 5.
Il primo revisore era Claude Opus. Quando il benchmark interno di Coinbase ha mostrato che le versioni più recenti di Opus, Sonnet e GPT ottenevano punteggi più bassi nell’individuare le frodi, il team ha addestrato invece Qwen3.5-9B sugli esiti storici dei casi di frode. Ha usato LoRA, un metodo che addestra un piccolo insieme di pesi aggiuntivi invece dell’intero modello. Il risultato:
- Addestramento: una GPU Nvidia, meno di 100 dollari.
- Qualità: migliore del revisore Opus 4.5 in tutte e quattro le metriche sulle frodi, tra cui un F1 superiore di 9,6 punti, il punteggio che bilancia le frodi individuate e i falsi allarmi.
- Velocità: un tempo di risposta mediano inferiore alla metà di quello del revisore Opus 4.5.
“I modelli di frontiera sono generalisti straordinari. Ma si vedranno sempre più spesso modelli specialistici dare risultati migliori su compiti più circoscritti, lavorando in squadra o da soli.”
Brian Armstrong, CEO di Coinbase, su X
Armstrong si aspetta che alcuni servizi di backend vengano “sostituiti interamente da questa nuova architettura”. Se succederà, i team avranno bisogno di un posto dove eseguire quei modelli specialistici, e l’addestramento è la parte economica: quello di Coinbase è costato meno di 100 dollari.
Un modello 9B su uno smartphone in cinque minuti
Compresso a circa 4 bit per peso, Qwen3.5-9B è un file da 5,7 GB. Usa GGUF, il formato di llama.cpp, il motore open source che esegue modelli linguistici su normali CPU. Uno smartphone top di gamma con 16 GB di RAM lo contiene con circa 0,8 GB di margine.
Il runtime Node.js di Acurast include già llama.cpp, e l’Acurast Tunnel dà a un deployment un indirizzo pubblico https://<id>.acu.run con un certificato reale. L’app di test, meno di 300 righe di JavaScript, ha aperto il tunnel, scaricato il modello da Hugging Face, misurato le prestazioni di alcune impostazioni del server, tenuto la più veloce e servito un’API compatibile con OpenAI. Girava solo su smartphone attestati. La prima risposta è arrivata circa cinque minuti dopo il comando di deploy. Niente GPU, niente account cloud, niente Docker.
Risultati dei benchmark di Qwen 3.5 9B sugli smartphone
Un LLM legge il prompt, un’operazione veloce perché avviene in parallelo, poi scrive la risposta un token alla volta. Sugli smartphone più veloci dei test, quelli di classe Snapdragon 8 Elite con MNN, Qwen3.5-9B ha letto il prompt fino a 85,2 token al secondo e ha scritto 9,3 token al secondo.
I modelli più piccoli della stessa famiglia sono molto più veloci, perché il limite degli smartphone è la velocità con cui spostano i pesi attraverso la memoria. L’animazione riproduce in tempo reale una risposta alla velocità di scrittura più alta misurata per ciascun modello.
Il modello 4B gira anche sugli smartphone da 8 GB, quindi i Processor idonei sono molti di più. Il modello 0.8B lascia la memoria in gran parte inutilizzata, così uno smartphone può servire più conversazioni insieme: anche uno smartphone da 8 GB ha servito quattro chat in parallelo a 46 token al secondo in totale.
Quanto costa
Un deployment fissa un prezzo massimo in ACU, l’utility token della rete, e il Matcher lo abbina agli smartphone che soddisfano i suoi requisiti. Per gli smartphone con almeno 12 GB di RAM, la media di mercato nel giorno del test era di 0,57 ACU per smartphone al giorno, e con 1,03 ACU si otteneva un abbinamento immediato. All’epoca erano circa 5-10 centesimi di dollaro. L’intero studio, circa 60 esecuzioni su smartphone, è costato circa 14 ACU.
Molte richieste in contemporanea
In un test più ampio sono stati noleggiati più di 100 smartphone ed è stato cronometrato un prompt reale da 7.000 token, la dimensione che legge il revisore di Coinbase. Il più veloce è stato uno smartphone da 16 GB con un chip di classe Snapdragon 8 Elite che eseguiva MNN, un motore open source di Alibaba, lo sviluppatore di Qwen. Ha letto il prompt in 3 minuti e 15 secondi con il modello 9B, in 1 minuto e 37 secondi con il 4B e in 15 secondi con lo 0.8B.
Tempo impiegato da uno smartphone per leggere un prompt da 7.000 token
Qwen3.5-9B
3 min 15 s
Qwen3.5-4B
1 min 37 s
Qwen3.5-0.8B
15 s
Misurato con un prompt reale da 7.000 token sullo smartphone più veloce di un test su 100 smartphone (16 GB, chip di classe Snapdragon 8 Elite), motore MNN, 8 thread della CPU, modelli a 4 bit.
Questi tempi si riferiscono a una sola richiesta su un solo smartphone. Ogni smartphone elabora le proprie richieste, quindi dieci repliche leggono dieci prompt nello stesso momento e cento ne leggono cento. Per una coda di revisione o un batch notturno, il numero che conta è quanto lavoro viene svolto in un’ora, e cresce con ogni smartphone aggiunto.
Dove si inserisce un modello specialistico su smartphone
La maggior parte del lavoro specialistico gira in coda e in background, dove throughput e disponibilità contano più della velocità di una singola risposta:
- Code di seconda revisione: chargeback, account segnalati e ticket di assistenza ricevono un primo verdetto entro un minuto, invece di aspettare per ore una persona.
- Guardie sempre attive: filtri anti-truffa per le chat delle community e controlli contro la prompt injection davanti agli agenti IA, che leggono messaggi brevi in pochi secondi.
- Valutazione in batch: ricontrollare durante la notte le transazioni del giorno prima, distribuite su tutti gli smartphone di cui il lavoro ha bisogno.
Le demo di Laya mostrano il lato degli input brevi: un classificatore su un solo smartphone che smista i messaggi truffa in 0,2-1 secondo.
Cosa aggiunge la rete: privacy, scalabilità e disponibilità
Privacy. I prompt arrivano al tuo deployment, non a un fornitore di modelli, ed è il motivo che Coinbase ha indicato per il self-hosting. Secondo la documentazione di Acurast, i Trusted Execution Environment (TEEs) degli smartphone “confermano che l’hardware è autentico e non contraffatto, e mantengono la riservatezza senza richiedere fiducia nel proprietario dello smartphone”. I segreti come la chiave API viaggiano come variabili d’ambiente cifrate, “decifrate solo quando il codice gira su un Processor”.
Scalabilità. Una sola configurazione ha fatto girare dieci smartphone, ognuno con il proprio indirizzo HTTPS fisso, e un test più ampio ne ha noleggiati più di 100 in un solo pomeriggio. Aggiungere capacità significa aumentare il numero di repliche: 137 smartphone soddisfacevano i requisiti del modello 0.8B, quindi la stessa configurazione con 100 repliche è già fattibile oggi.
Disponibilità. Un deployment distribuito su smartphone in molti luoghi diversi non dipende da un singolo data center che possa fermarsi. Le repliche di riserva mantengono la coda in movimento ogni volta che uno smartphone è occupato o offline, e la stessa configurazione può essere ridistribuita su nuovi smartphone in qualsiasi momento.
Esegui il tuo modello
Il codice alla base di questo articolo è open source. L’esempio Qwen tra le app di esempio di Acurast esegue Qwen3.5 su uno smartphone dietro un’API compatibile con OpenAI, e si apre nel playground di Acurast Hub senza alcun passaggio di build. Un secondo esempio, LLM on MNN, serve la stessa API con il motore MNN che sta dietro ai numeri più veloci di questo articolo, e si trova anch’esso nel playground. La guida agli LLM nella documentazione di Acurast spiega come caricare un modello in un deployment, e la guida rapida all’Acurast Tunnel tratta l’indirizzo HTTPS pubblico. Se affini un modello come ha fatto Coinbase, unisci i pesi LoRA al modello prima di convertirlo: il risultato ha le stesse dimensioni e la stessa velocità del modello di base.
Costruisci su Acurast? Se stai addestrando i tuoi modelli specialistici e vuoi servirli su smartphone attestati, vieni a confrontarti nel Discord di Acurast.