LLM auto-hébergé sur un téléphone : le modèle 9B que Coinbase a affiné pour battre Opus
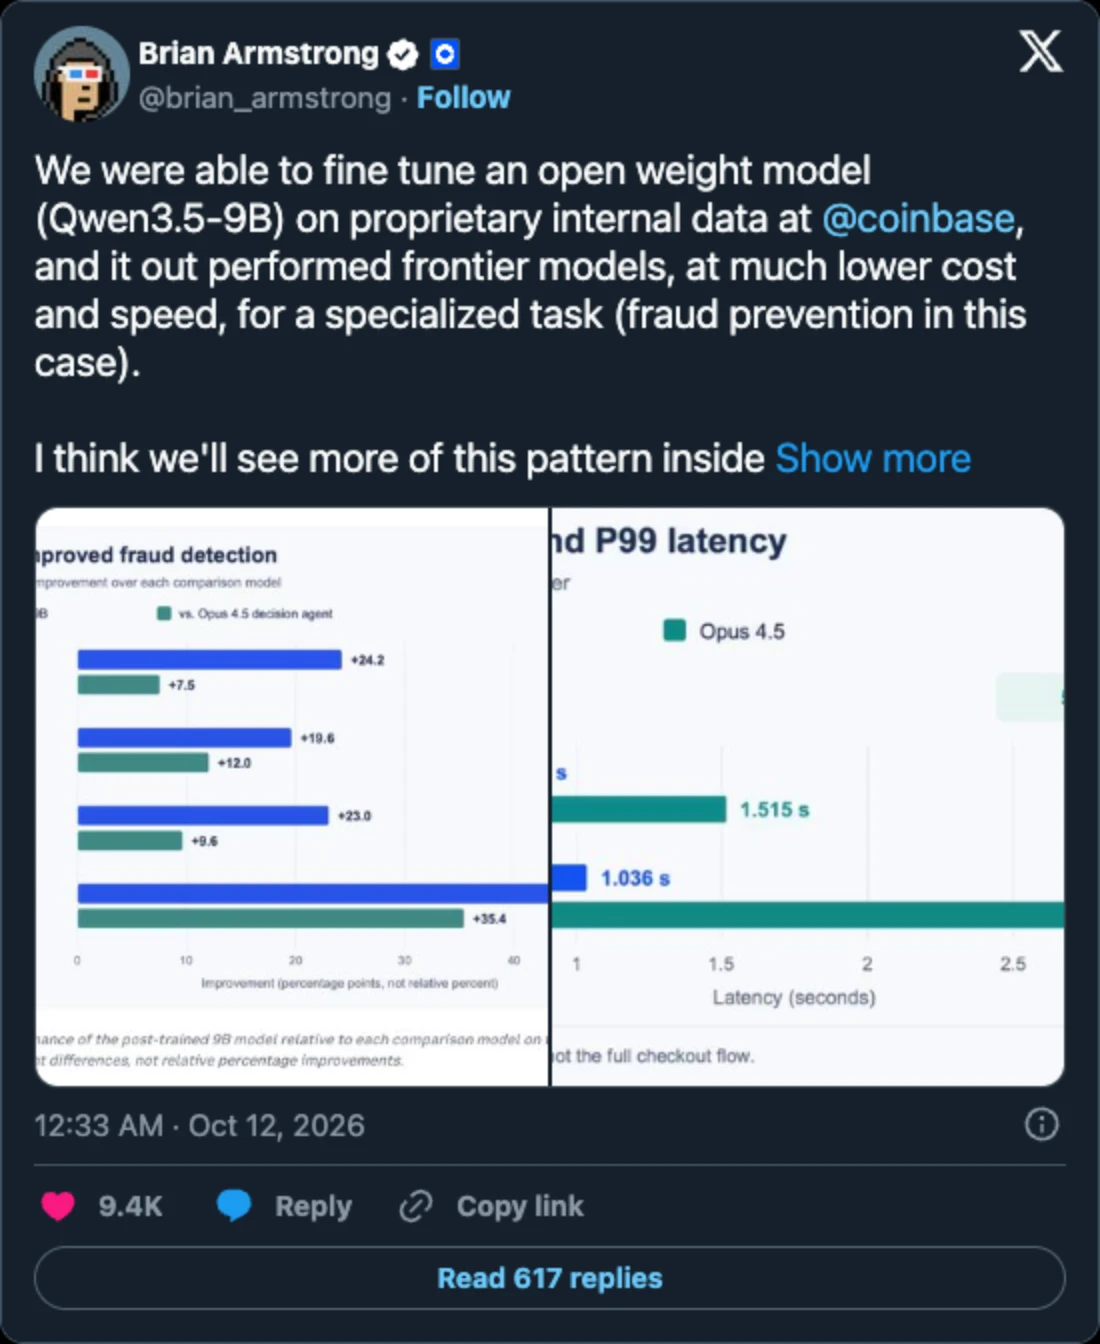
Le 12 octobre, Brian Armstrong, CEO de Coinbase, a expliqué dans une publication que ses ingénieurs avaient affiné Qwen3.5-9B, un modèle gratuit à poids ouverts, sur des données internes, et que ce modèle battait les modèles de pointe en prévention de la fraude. La publication a dépassé les 1,6 million de vues. Avec neuf milliards de paramètres, le modèle est assez petit pour devenir un LLM auto-hébergé qu’une entreprise possède entièrement : Coinbase l’a entraîné pour moins de 100 $ et le sert elle-même au lieu d’appeler l’API d’un fournisseur.
Ce modèle est aussi assez petit pour un téléphone. Qwen3.5-9B tourne sur des téléphones Android de 16 Go du réseau Acurast, derrière une adresse HTTPS qui expose la même API que celle d’OpenAI, pour environ 0,6 à 1 ACU par téléphone et par jour. Les mesures présentées ici proviennent de tests sur le mainnet d’Acurast, y compris la manière dont un même modèle se répartit sur autant de téléphones que le travail l’exige.
Ce que Coinbase a construit
Coinbase Onramp permet d’acheter de la crypto dans des applications partenaires, parfois en tant qu’invité, sans historique de compte. Pour y repérer la fraude, Coinbase a ajouté un LLM vérificateur derrière ses règles existantes. Il lit environ 7 000 tokens de contexte par transaction (un token est un fragment de mot, soit environ trois quarts de mot) et répond par une seule ligne, comme RISK_LEVEL: 5.
Le premier vérificateur était Claude Opus. Lorsque le propre benchmark de Coinbase a montré que les nouvelles versions d’Opus, de Sonnet et de GPT détectaient moins bien la fraude, l’équipe a plutôt entraîné Qwen3.5-9B sur ses données historiques de fraude. Elle a utilisé LoRA, une méthode qui entraîne un petit ensemble de poids supplémentaires plutôt que le modèle entier. Le résultat :
- Entraînement : un seul GPU Nvidia, moins de 100 $.
- Qualité : meilleur que le vérificateur Opus 4.5 sur les quatre indicateurs de fraude, dont un F1 supérieur de 9,6 points, le score qui met en balance la détection de la fraude et les fausses alertes.
- Vitesse : un temps de réponse médian inférieur à la moitié de celui du vérificateur Opus 4.5.
« Les modèles de pointe sont des généralistes extraordinaires. Mais on verra de plus en plus de modèles spécialisés les surpasser sur des tâches plus ciblées, que ce soit en équipe ou seuls. »
Brian Armstrong, CEO de Coinbase, sur X
Armstrong s’attend à ce que certains services backend soient « entièrement remplacés par cette nouvelle architecture ». Si cela se produit, les équipes auront besoin d’un endroit où faire tourner ces modèles spécialisés, et l’entraînement est la partie la moins coûteuse : celui de Coinbase a coûté moins de 100 $.
Un modèle 9B sur un téléphone en cinq minutes
Compressé à environ 4 bits par poids, Qwen3.5-9B tient dans un fichier de 5,7 Go. Il utilise GGUF, le format de llama.cpp, le moteur open source qui fait tourner des modèles de langage sur des CPU ordinaires. Un téléphone haut de gamme doté de 16 Go de RAM le contient avec environ 0,8 Go de marge.
Le runtime Node.js d’Acurast intègre llama.cpp, et l’Acurast Tunnel donne à un déploiement une adresse publique https://<id>.acu.run avec un vrai certificat. L’application de test, moins de 300 lignes de JavaScript, a ouvert le tunnel, téléchargé le modèle depuis Hugging Face, comparé quelques réglages de serveur, conservé le plus rapide et exposé une API compatible OpenAI. Elle ne tournait que sur des téléphones attestés. La première réponse est arrivée environ cinq minutes après la commande de déploiement. Ni GPU, ni compte cloud, ni Docker.
Résultats du benchmark de Qwen 3.5 9B sur téléphones
Un LLM lit le prompt, ce qui est rapide car cela se fait en parallèle, puis écrit la réponse un token à la fois. Sur les téléphones les plus rapides des tests, dotés d’une puce de la classe Snapdragon 8 Elite et exécutant MNN, Qwen3.5-9B a lu le prompt à une vitesse allant jusqu’à 85,2 tokens par seconde et a écrit 9,3 tokens par seconde.
Les modèles plus petits de la même famille sont bien plus rapides, car les téléphones sont limités par la vitesse à laquelle ils font transiter les poids par la mémoire. L’animation rejoue une réponse en temps réel, à la vitesse d’écriture la plus élevée mesurée pour chaque modèle.
Le modèle 4B tourne aussi sur des téléphones de 8 Go, si bien que beaucoup plus de Processors remplissent les conditions. Le modèle 0.8B laisse la mémoire en grande partie inutilisée, de sorte qu’un seul téléphone peut servir plusieurs conversations à la fois : même un téléphone de 8 Go a servi quatre chats en parallèle à 46 tokens par seconde au total.
Ce que cela coûte
Un déploiement fixe un prix maximal en ACU, le token utilitaire du réseau, et le Matcher l’associe à des téléphones qui répondent à ses exigences. Pour les téléphones dotés d’au moins 12 Go de RAM, la moyenne du marché le jour du test était de 0,57 ACU par téléphone et par jour, et 1,03 ACU permettait d’obtenir un appariement immédiat. Cela représentait environ 5 à 10 centimes de dollar américain à l’époque. L’étude complète, une soixantaine d’exécutions sur téléphone, a coûté environ 14 ACU.
De nombreuses requêtes à la fois
Un test à plus grande échelle a loué plus de 100 téléphones et chronométré un vrai prompt de 7 000 tokens, la taille de ce que lit le vérificateur de Coinbase. Le plus rapide était un téléphone de 16 Go doté d’une puce de la classe Snapdragon 8 Elite et exécutant MNN, un moteur open source d’Alibaba, le développeur de Qwen. Il a lu le prompt en 3 minutes 15 secondes avec le modèle 9B, en 1 minute 37 secondes avec le 4B et en 15 secondes avec le 0.8B.
Temps de lecture d’un prompt de 7 000 tokens sur un téléphone
Qwen3.5-9B
3 min 15 s
Qwen3.5-4B
1 min 37 s
Qwen3.5-0.8B
15 s
Mesuré avec un vrai prompt de 7 000 tokens sur le téléphone le plus rapide d’un test portant sur 100 téléphones (16 Go, puce de la classe Snapdragon 8 Elite), moteur MNN, 8 threads CPU, modèles 4 bits.
Ces temps valent pour une requête sur un téléphone. Chaque téléphone traite ses propres requêtes : dix réplicas lisent donc dix prompts en même temps, et cent en lisent cent. Pour une file de vérification ou un traitement par lots nocturne, le chiffre qui compte est le volume traité par heure, et il augmente avec chaque téléphone ajouté.
La place d’un modèle spécialisé hébergé sur téléphone
La plupart des tâches spécialisées tournent en file d’attente et en arrière-plan, là où le débit et la disponibilité comptent davantage que la vitesse d’une réponse isolée :
- Files de seconde vérification : rétrofacturations, comptes signalés et tickets de support obtiennent un premier verdict en moins d’une minute au lieu d’attendre des heures qu’une personne s’en charge.
- Gardiens toujours actifs : filtres anti-arnaque pour les chats communautaires et contrôles contre l’injection de prompt en amont des agents d’IA, qui lisent des messages courts en quelques secondes.
- Évaluation par lots : revérifier pendant la nuit les transactions de la veille, en répartissant le travail sur autant de téléphones que nécessaire.
Les démos de Laya illustrent le cas des entrées courtes : un classificateur sur un seul téléphone trie les messages d’arnaque en 0,2 à 1 seconde.
Ce qu’apporte le réseau : confidentialité, mise à l’échelle et disponibilité
Confidentialité. Les prompts sont envoyés à votre propre déploiement, et non à un fournisseur de modèles, ce qui est la raison avancée par Coinbase pour l’auto-hébergement. Selon la documentation d’Acurast, les environnements d’exécution de confiance (Trusted Execution Environments, TEEs) des smartphones « confirment que le matériel est authentique et non contrefait, et préservent la confidentialité sans exiger de faire confiance au propriétaire du téléphone ». Les secrets comme la clé d’API transitent sous forme de variables d’environnement chiffrées, « déchiffrées uniquement lorsque le code s’exécute sur un Processor ».
Mise à l’échelle. Une seule configuration a fait tourner dix téléphones, chacun avec sa propre adresse HTTPS fixe, et un test à plus grande échelle en a loué plus de 100 en un après-midi. Ajouter de la capacité revient à augmenter le nombre de réplicas : 137 téléphones remplissaient les exigences du modèle 0.8B, si bien que la même configuration avec 100 réplicas est réalisable dès aujourd’hui.
Disponibilité. Un déploiement réparti sur des téléphones situés en de nombreux endroits ne dépend d’aucun centre de données unique susceptible de tomber en panne. Des réplicas de réserve font avancer la file dès qu’un téléphone est occupé ou hors ligne, et la même configuration peut être redéployée sur de nouveaux téléphones à tout moment.
Faites tourner votre propre modèle
Le code derrière cet article est ouvert. L’exemple Qwen des applications d’exemple Acurast fait tourner Qwen3.5 sur un téléphone derrière une API compatible OpenAI, et il s’ouvre dans le playground de l’Acurast Hub sans étape de compilation. Un deuxième exemple, LLM on MNN, expose la même API avec le moteur MNN à l’origine des chiffres les plus rapides de cet article, et se trouve lui aussi dans le playground. Le guide LLM de la documentation d’Acurast explique comment charger un modèle dans un déploiement, et le guide de démarrage rapide de l’Acurast Tunnel couvre l’adresse HTTPS publique. Si vous affinez un modèle comme l’a fait Coinbase, fusionnez les poids LoRA dans le modèle avant de le convertir : le résultat a la même taille et la même vitesse que le modèle de base.
Vous développez sur Acurast ? Si vous entraînez vos propres modèles spécialisés et souhaitez les faire tourner sur des téléphones attestés, venez échanger vos expériences sur le Discord d’Acurast.