手机上的自托管LLM:Coinbase微调后胜过Opus的9B模型
10月12日,Coinbase CEO Brian Armstrong发帖称,他的工程师用内部数据微调了免费的开放权重模型Qwen3.5-9B,而它在欺诈防范上胜过了前沿模型。这条帖子的浏览量已超过160万次。90亿参数的规模足够小,可以成为一家公司完全自有的自托管LLM:Coinbase训练它只花了不到100美元,并自行提供服务,而不是调用供应商的API。
它也小到足以在手机上运行。Qwen3.5-9B运行在Acurast网络中16 GB的Android手机上,通过一个HTTPS地址提供与OpenAI相同的API,每部手机每天约0.6到1 ACU。本文的测量数据来自在Acurast主网上进行的测试,其中包括同一个模型如何按需扩展到工作所需数量的手机上。
Coinbase构建了什么
Coinbase Onramp让人们可以在合作伙伴的应用内购买加密货币,有时是以没有任何账户历史的访客身份购买。为了在这一环节识别欺诈,Coinbase在现有规则之后加入了一个LLM审核器。它每笔交易读取约7,000个token的上下文(token是词的片段,大约相当于四分之三个单词),并只用一行作答,例如RISK_LEVEL: 5。
最初的审核器是Claude Opus。当Coinbase自己的基准测试显示,较新的Opus、Sonnet和GPT版本在识别欺诈方面得分反而更低时,团队转而用自己的历史欺诈结果训练了Qwen3.5-9B。训练采用LoRA,这种方法只训练一小组额外的权重,而不是整个模型。结果如下:
- 训练:一块Nvidia GPU,不到100美元。
- 质量:在全部四项欺诈指标上均优于Opus 4.5审核器,其中F1高出9.6个点;F1是在识别欺诈与避免误报之间取得平衡的评分。
- 速度:回答时间的中位数不到Opus 4.5审核器的一半。
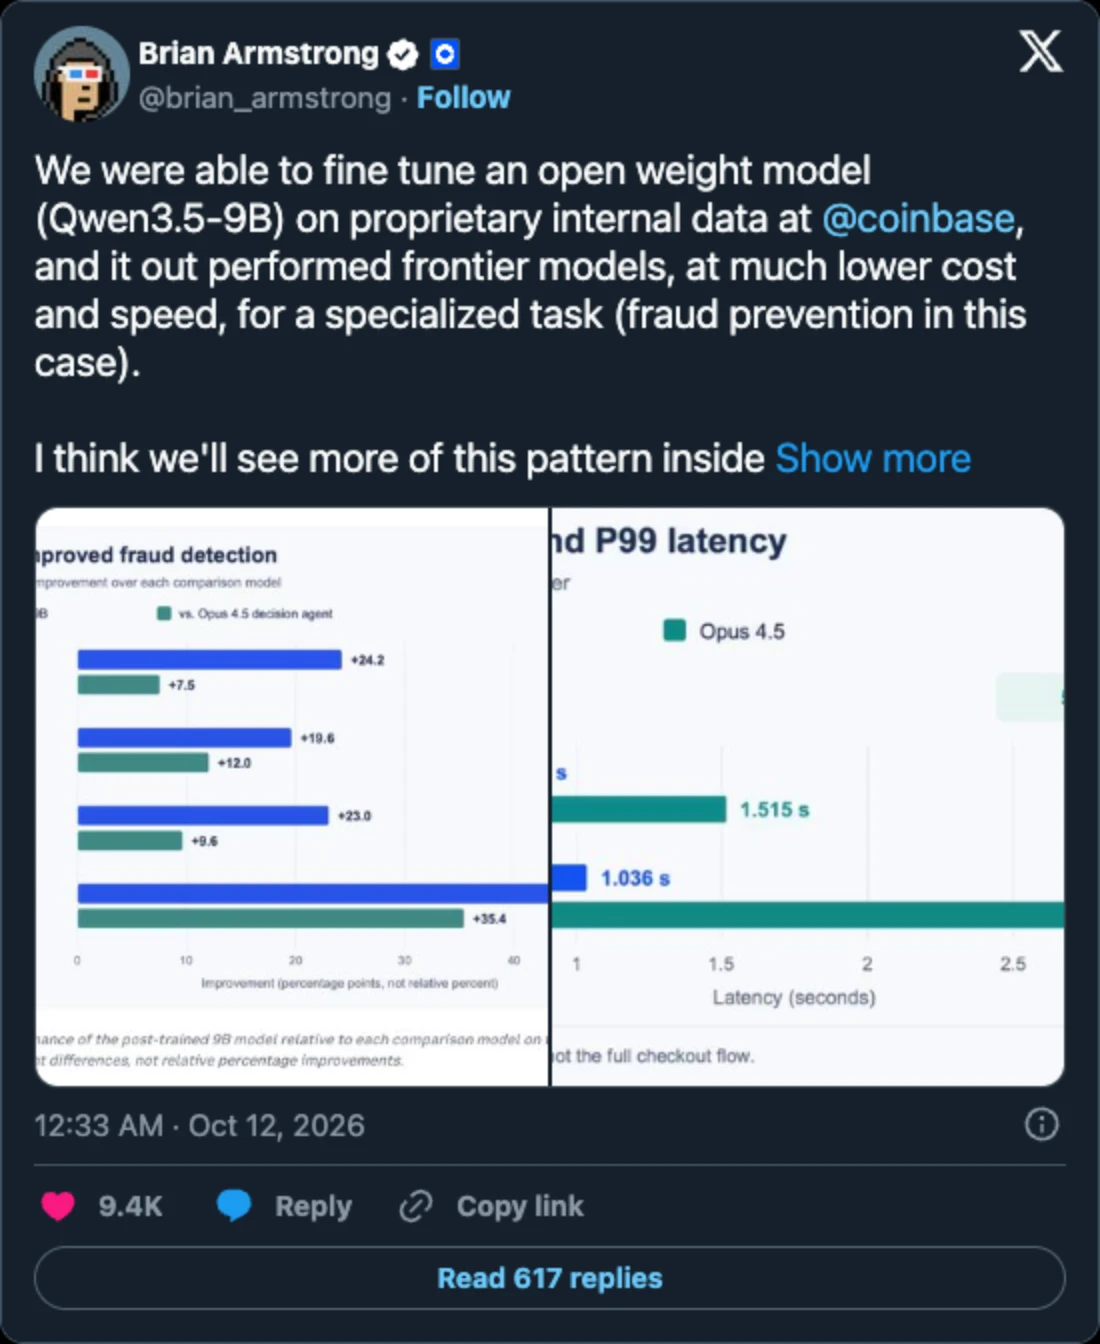
Armstrong预计,一些后端服务将“完全被这种新架构所取代”。果真如此,团队就需要一个运行这些专用模型的地方,而训练恰恰是便宜的部分:Coinbase的那次训练只花了不到100美元。
五分钟内在手机上运行9B模型
压缩到每个权重约4比特后,Qwen3.5-9B是一个5.7 GB的文件。它采用GGUF格式,即llama.cpp的格式;llama.cpp是一个在普通CPU上运行语言模型的开源引擎。一部拥有16 GB内存的旗舰手机可以装下它,还剩约0.8 GB的余量。
Acurast的Node.js运行时内置了llama.cpp,而Acurast Tunnel为部署提供一个带真实证书的公共https://<id>.acu.run地址。测试应用只有不到300行JavaScript:它打开隧道,从Hugging Face下载模型,对几种服务器设置进行基准测试,保留最快的一种,并提供兼容OpenAI的API。它只在经过证明的手机上运行。部署命令发出约五分钟后,第一个回答就已返回。无需GPU,无需云账户,也无需Docker。
Qwen 3.5 9B在手机上的基准测试结果
LLM先读取提示词,这一步很快,因为它是并行进行的;然后再逐个token写出回答。在测试中最快的手机上,也就是运行MNN的Snapdragon 8 Elite级手机上,Qwen3.5-9B读取提示词的速度最高可达每秒85.2个token,写出速度为每秒9.3个token。
同一系列中更小的模型要快得多,因为手机的速度受限于在内存中搬运权重的快慢。动画按照每个模型实测的最快写出速度,实时重放一个回答。
4B模型也能在8 GB手机上运行,因此符合条件的Processor要多得多。0.8B模型让内存大部分处于空闲状态,因此一部手机可以同时服务多个对话:即使是一部8 GB手机,在服务四个并行聊天时,合计速度也达到了每秒46个token。
费用是多少
部署以ACU(网络的功能型代币)设定最高价格,匹配者(Matcher)随后将其与满足要求的手机配对。对于内存为12 GB及以上的手机,测试当天的市场均价为每部手机每天0.57 ACU,而1.03 ACU即可获得即时匹配。这在当时约合5到10美分。整个研究共进行了约60次手机运行,花费约14 ACU。
同时处理大量请求
一次规模更大的测试租用了100多部手机,并对一条真实的7,000个token的提示词进行计时,这正是Coinbase审核器读取的规模。最快的是一部16 GB手机,搭载Snapdragon 8 Elite级芯片,运行MNN;MNN是Qwen的开发者Alibaba推出的开源引擎。这部手机读完这条提示词,9B模型用时3分15秒,4B用时1分37秒,0.8B用时15秒。
一部手机读取7,000个token提示词所需的时间
Qwen3.5-9B
3分15秒
Qwen3.5-4B
1分37秒
Qwen3.5-0.8B
15秒
实测于一次100部手机测试中最快的那部手机(16 GB,Snapdragon 8 Elite级芯片),使用一条真实的7,000个token提示词,MNN引擎,8个CPU线程,4比特模型。
以上是一部手机处理一个请求所用的时间。每部手机各自处理自己的请求,因此十个副本可以同时读取十条提示词,一百个副本就能同时读取一百条。对于审核队列或夜间批处理来说,真正重要的是每小时能完成多少工作,而这个数字会随着每增加一部手机而增长。
手机托管的专用模型适合哪些场景
大多数专用模型的工作都在队列和后台中运行,在这些场景下,吞吐量和可用性比单个回答的速度更重要:
- 复核队列:拒付申请、被标记的账户和支持工单在一分钟内就能得到初步判定,而不必花几个小时等人来处理。
- 全天候防护:社区聊天的诈骗过滤器,以及部署在AI智能体之前的提示词注入检查,它们能在几秒内读完简短的消息。
- 批量评分:在夜间重新检查前一天的交易,并分布到任务所需数量的手机上。
Laya演示展示了其中短输入的一端:一部手机上的分类器能在0.2到1秒内分拣诈骗消息。
网络带来什么:隐私、规模和可用性
隐私。提示词发送到您自己的部署,而不是模型供应商,这正是Coinbase给出的选择自托管的理由。根据Acurast文档,智能手机的可信执行环境(TEEs)“确认硬件是真实的而非伪造的,并且无需信任手机持有人即可保持机密性”。API密钥等机密信息以加密环境变量的形式传输,“仅在代码于Processor上运行时才会解密”。
规模。一份配置运行了十部手机,每部都有自己固定的HTTPS地址;一次规模更大的测试则在一个下午内租用了100多部手机。增加容量只需提高副本数:共有137部手机满足0.8B模型的要求,因此如今将同一份配置设为100个副本即可运行。
可用性。分布在多地手机上的部署,不存在可能宕机的单一数据中心。每当某部手机繁忙或离线时,备用副本都能让队列继续推进,而且同一份配置随时可以重新部署到新的手机上。
运行您自己的模型
本文背后的代码是开源的。Acurast示例应用中的Qwen示例在手机上运行Qwen3.5,并通过兼容OpenAI的API提供服务,而且无需构建步骤即可在Acurast Hub Playground中打开。第二个示例LLM on MNN使用MNN引擎提供相同的API,本文中最快的数据正是出自这一引擎,该示例同样可以在Playground中找到。Acurast文档中的LLM指南介绍了如何在部署中加载模型,而Acurast Tunnel快速入门则介绍了公共HTTPS地址。如果您像Coinbase一样进行微调,请在转换模型之前先将LoRA权重合并到模型中:这样得到的模型与基础模型的大小和速度都相同。
在Acurast上构建?如果您正在训练自己的专用模型,并希望在经过证明的手机上提供服务,欢迎来Acurast Discord交流经验。