LLM auto-hospedado em um celular: o modelo 9B que a Coinbase ajustou para superar o Opus
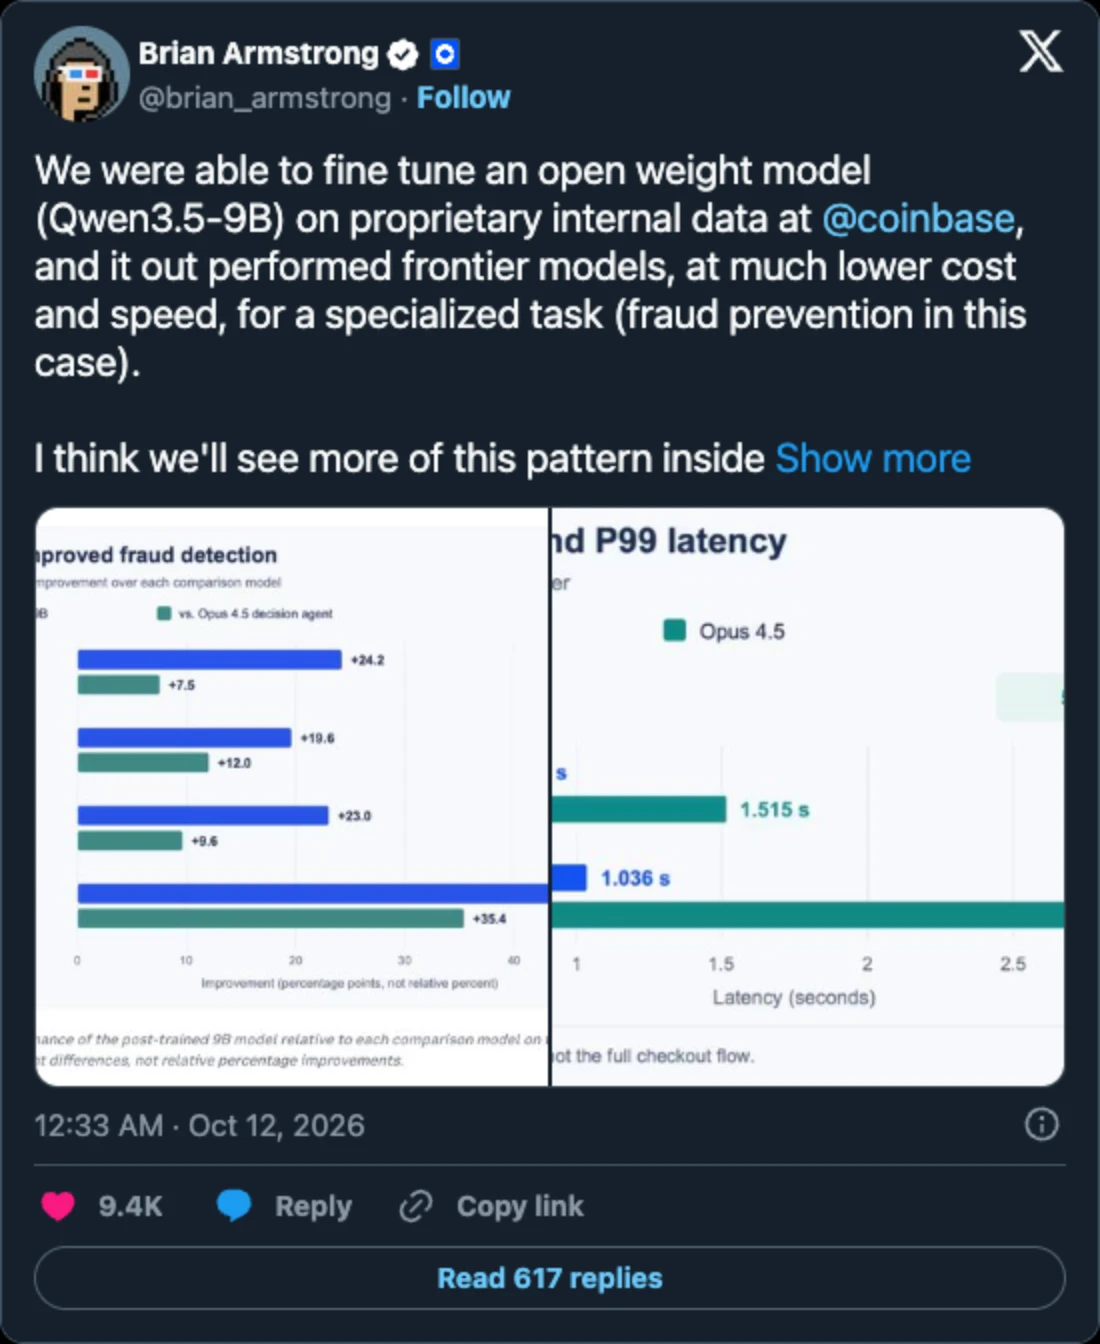
Em 12 de outubro, o CEO da Coinbase, Brian Armstrong, publicou que seus engenheiros tinham feito o ajuste fino do Qwen3.5-9B, um modelo gratuito e de pesos abertos, com dados internos, e que ele superou os modelos de fronteira na prevenção de fraudes. A publicação já passou de 1,6 milhão de visualizações. Com nove bilhões de parâmetros, o modelo é pequeno o bastante para ser um LLM auto-hospedado que pertence inteiramente a uma empresa: a Coinbase o treinou por menos de US$ 100 e roda o modelo por conta própria, em vez de chamar a API de um fornecedor.
Também é pequeno o bastante para um celular. O Qwen3.5-9B roda em celulares Android de 16 GB na rede Acurast, por trás de um endereço HTTPS que usa a mesma API da OpenAI, por cerca de 0,6 a 1 ACU por celular por dia. As medições aqui vêm de testes na mainnet da Acurast, incluindo como um único modelo escala para tantos celulares quanto o trabalho exigir.
O que a Coinbase construiu
O Coinbase Onramp permite que as pessoas comprem cripto dentro de apps parceiros, às vezes como convidadas, sem histórico de conta. Para detectar fraudes ali, a Coinbase adicionou um revisor baseado em LLM depois das regras que já existiam. Ele lê cerca de 7.000 tokens de contexto por transação (um token é um fragmento de palavra, cerca de três quartos de uma palavra) e responde com uma única linha, como RISK_LEVEL: 5.
O primeiro revisor foi o Claude Opus. Quando o benchmark da própria Coinbase mostrou versões mais novas do Opus, do Sonnet e do GPT com pontuações mais baixas na detecção de fraudes, a equipe passou a treinar o Qwen3.5-9B com o histórico de casos de fraude da empresa. Para isso, usou LoRA, um método que treina um pequeno conjunto de pesos extras em vez do modelo inteiro. O resultado:
- Treinamento: uma GPU Nvidia, menos de US$ 100.
- Qualidade: melhor que o revisor Opus 4.5 em todas as quatro métricas de fraude, incluindo um F1 9,6 pontos maior, a pontuação que equilibra a detecção de fraudes e os alarmes falsos.
- Velocidade: tempo mediano de resposta inferior à metade do tempo do revisor Opus 4.5.
“Os modelos de fronteira são generalistas incríveis. Mas, cada vez mais, você vai ver modelos especialistas com desempenho superior em tarefas mais específicas, seja trabalhando em equipe, seja sozinhos.”
Brian Armstrong, CEO da Coinbase, no X
Armstrong espera que alguns serviços de backend sejam “substituídos inteiramente por essa nova arquitetura”. Se isso acontecer, as equipes vão precisar de um lugar para rodar esses modelos especialistas, e o treinamento é a parte barata: o da Coinbase custou menos de US$ 100.
Um modelo 9B em um celular em cinco minutos
Comprimido para cerca de 4 bits por peso, o Qwen3.5-9B é um arquivo de 5,7 GB. Ele usa GGUF, o formato do llama.cpp, o motor de código aberto que roda modelos de linguagem em CPUs comuns. Um celular topo de linha com 16 GB de RAM comporta o modelo com cerca de 0,8 GB de folga.
O runtime Node.js da Acurast já vem com o llama.cpp integrado, e o Acurast Tunnel dá a um deployment um endereço público https://<id>.acu.run com um certificado real. O app de teste, com menos de 300 linhas de JavaScript, abriu o túnel, baixou o modelo do Hugging Face, testou algumas configurações de servidor, manteve a mais rápida e disponibilizou uma API compatível com OpenAI. Ele rodou apenas em celulares atestados. A primeira resposta chegou cerca de cinco minutos depois do comando de deploy. Sem GPU, sem conta de nuvem, sem Docker.
Resultados de benchmark do Qwen 3.5 9B em celulares
Um LLM lê o prompt, o que é rápido porque acontece em paralelo, e depois escreve a resposta um token por vez. Nos celulares mais rápidos dos testes, celulares da classe Snapdragon 8 Elite rodando MNN, o Qwen3.5-9B leu o prompt a até 85,2 tokens por segundo e escreveu 9,3 tokens por segundo.
Modelos menores da mesma família são muito mais rápidos, porque o limite dos celulares é a velocidade com que movem os pesos pela memória. A animação reproduz uma resposta na maior velocidade de escrita medida para cada modelo, em tempo real.
O modelo 4B também roda em celulares de 8 GB, então muito mais Processors se qualificam. O modelo 0.8B deixa a memória quase ociosa, então um celular pode atender várias conversas ao mesmo tempo: até um celular de 8 GB atendeu quatro chats em paralelo a 46 tokens por segundo no total.
Quanto custa
Um deployment define um preço máximo em ACU, o token utilitário da rede, e o Matcher o combina com celulares que atendem aos seus requisitos. Para celulares com 12 GB de RAM ou mais, a média do mercado no dia do teste foi de 0,57 ACU por celular por dia, e 1,03 ACU bastava para um pareamento imediato. Na época, isso equivalia a cerca de 5 a 10 centavos de dólar. O estudo inteiro, com cerca de 60 execuções em celulares, custou aproximadamente 14 ACU.
Muitas requisições ao mesmo tempo
Um teste maior alugou mais de 100 celulares e cronometrou um prompt real de 7.000 tokens, o tamanho que o revisor da Coinbase lê. O mais rápido foi um celular de 16 GB com chip da classe Snapdragon 8 Elite rodando MNN, um motor de código aberto da Alibaba, a desenvolvedora do Qwen. Ele leu o prompt em 3 minutos e 15 segundos com o modelo 9B, 1 minuto e 37 segundos com o 4B e 15 segundos com o 0.8B.
Tempo para um celular ler um prompt de 7.000 tokens
Qwen3.5-9B
3 min 15 s
Qwen3.5-4B
1 min 37 s
Qwen3.5-0.8B
15 s
Medido com um prompt real de 7.000 tokens no celular mais rápido de um teste com 100 celulares (16 GB, chip da classe Snapdragon 8 Elite), motor MNN, 8 threads de CPU, modelos de 4 bits.
Esses tempos valem para uma requisição em um celular. Cada celular processa as próprias requisições, então dez réplicas leem dez prompts ao mesmo tempo, e cem leem cem. Para uma fila de revisão ou um lote noturno, o número que conta é quanto trabalho é feito por hora, e ele cresce a cada celular adicionado.
Onde um especialista hospedado em celular se encaixa
A maior parte do trabalho especializado roda em filas e em segundo plano, onde a vazão e a disponibilidade contam mais do que a velocidade de uma única resposta:
- Filas de segunda análise: chargebacks, contas sinalizadas e tickets de suporte recebem um primeiro veredito em até um minuto, em vez de esperar horas por uma pessoa.
- Proteções sempre ativas: filtros de golpes para chats de comunidades e verificações contra injeção de prompt na frente de agentes de IA, que leem mensagens curtas em segundos.
- Pontuação em lote: reverificar durante a noite as transações do dia anterior, distribuídas por tantos celulares quanto o trabalho precisar.
As demos do Laya mostram o lado das entradas curtas: um classificador em um único celular separando mensagens de golpe em 0,2 a 1 segundo.
O que a rede acrescenta: privacidade, escala e disponibilidade
Privacidade. Os prompts vão para o seu próprio deployment, não para um fornecedor de modelos, e esse é o motivo que a Coinbase deu para a auto-hospedagem. Segundo a documentação da Acurast, os Trusted Execution Environments (TEEs) dos smartphones “confirmam que o hardware é genuíno e não falso, e mantêm a confidencialidade sem exigir confiança no dono do celular”. Segredos como a chave de API trafegam como variáveis de ambiente criptografadas, “descriptografadas apenas quando o código roda em um Processor”.
Escala. Uma única configuração rodou dez celulares, cada um com o seu próprio endereço HTTPS fixo, e um teste maior alugou mais de 100 em uma tarde. Adicionar capacidade significa aumentar o número de réplicas: 137 celulares atendiam aos requisitos do modelo 0.8B, então a mesma configuração com 100 réplicas cabe na rede hoje.
Disponibilidade. Um deployment distribuído por celulares em muitos lugares não depende de um único data center que possa cair. Réplicas extras mantêm a fila andando sempre que um celular está ocupado ou offline, e a mesma configuração pode ser implantada de novo em outros celulares a qualquer momento.
Rode o seu próprio modelo
O código por trás deste artigo é aberto. O exemplo do Qwen nos apps de exemplo da Acurast roda o Qwen3.5 em um celular por trás de uma API compatível com OpenAI e abre no playground do Acurast Hub sem etapa de build. Um segundo exemplo, LLM on MNN, oferece a mesma API com o motor MNN, responsável pelos números mais rápidos deste artigo, e também está no playground. O guia de LLM na documentação da Acurast explica como carregar um modelo em um deployment, e o quickstart do Acurast Tunnel cobre o endereço HTTPS público. Se você fizer ajuste fino como a Coinbase, mescle os pesos LoRA ao modelo antes de convertê-lo: o resultado tem o mesmo tamanho e a mesma velocidade do modelo base.
Construindo na Acurast? Se você está treinando os seus próprios modelos especialistas e quer rodá-los em celulares atestados, venha trocar experiências no Discord da Acurast.