手機上的自架LLM:Coinbase微調後勝過Opus的9B模型
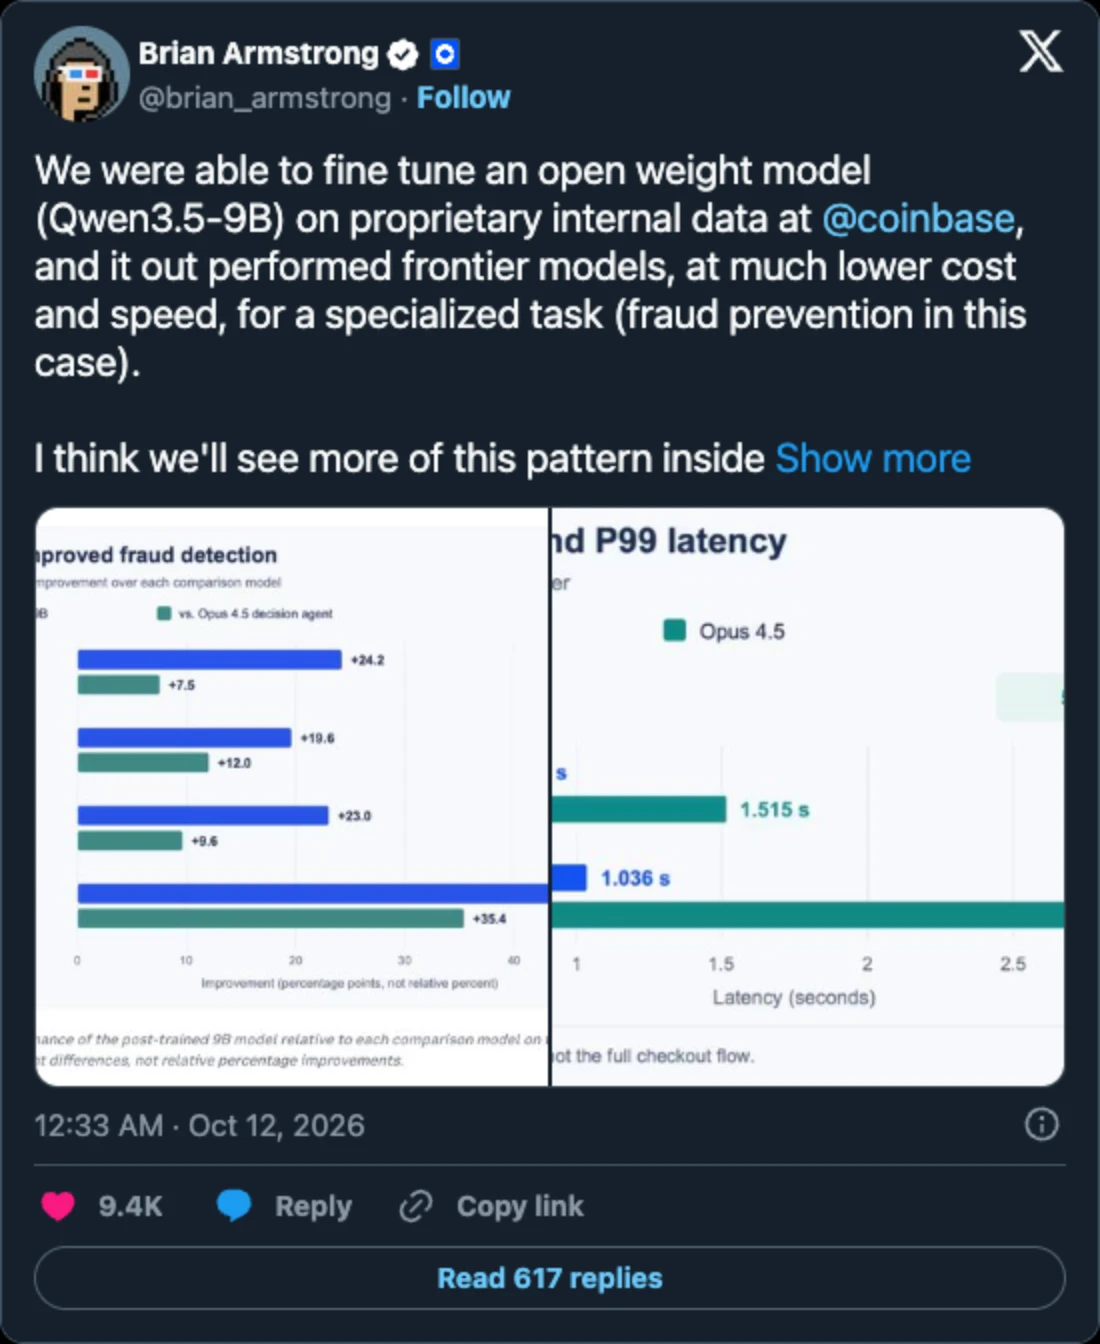
10月12日,Coinbase執行長Brian Armstrong發文表示,他的工程師以內部資料微調了免費的開放權重模型Qwen3.5-9B,而它在詐欺防範上勝過了前沿模型。這則貼文的瀏覽次數已超過160萬次。90億個參數的規模,小到足以成為一家公司完全擁有的自架LLM:Coinbase訓練它的成本不到100美元,而且由自己提供服務,不必呼叫供應商的API。
它也小到足以放進手機。Qwen3.5-9B在Acurast網路中16 GB的Android手機上執行,透過一個與OpenAI使用相同API的HTTPS位址提供服務,每支手機每天只需約0.6到1 ACU。本文的測量結果來自Acurast主網上進行的測試,其中也包括單一模型如何擴展到工作所需數量的手機上。
Coinbase打造了什麼
Coinbase Onramp讓人們在合作夥伴的應用程式內購買加密貨幣,有時甚至是以沒有帳戶紀錄的訪客身分購買。為了在這裡揪出詐欺,Coinbase在既有規則之後,加上了一個LLM審查員。它每筆交易讀取約7,000個token的情境資訊(token是字詞的片段,大約相當於四分之三個英文單字),並只用一行回答,例如RISK_LEVEL: 5。
最初的審查員是Claude Opus。當Coinbase自己的基準測試顯示,較新版本的Opus、Sonnet與GPT在揪出詐欺上的得分反而更低時,團隊改用歷來的詐欺案例結果來訓練Qwen3.5-9B。訓練採用LoRA,這種方法只訓練一小組額外的權重,而非整個模型。結果:
- 訓練:一張Nvidia GPU,成本不到100美元。
- 品質:在全部四項詐欺指標上都優於Opus 4.5審查員,其中F1分數高出9.6分;F1是在揪出詐欺與避免誤報之間取得平衡的分數。
- 速度:回答時間的中位數,不到Opus 4.5審查員的一半。
Armstrong預期,部分後端服務將「完全被這種新架構取代」。一旦如此,各個團隊就需要一個執行這些專精模型的地方,而訓練是其中便宜的部分:Coinbase的訓練花費不到100美元。
五分鐘讓9B模型在手機上執行
壓縮到每個權重約4位元後,Qwen3.5-9B是一個5.7 GB的檔案。它採用GGUF格式,也就是llama.cpp使用的格式;llama.cpp是在一般CPU上執行語言模型的開源引擎。一支配備16 GB記憶體的旗艦手機就能容納它,還剩下約0.8 GB的空間。
Acurast的Node.js執行環境內建llama.cpp,而Acurast Tunnel則為部署提供一個公開的https://<id>.acu.run位址,並附有正式憑證。測試應用程式只有不到300行JavaScript,它開啟通道、從Hugging Face下載模型、對幾種伺服器設定進行基準測試、保留最快的一種,並提供相容OpenAI的API。它只在經認證的手機上執行。下達部署指令後約五分鐘,第一個回答就出現了。不需要GPU,不需要雲端帳戶,也不需要Docker。
Qwen 3.5 9B在手機上的基準測試結果
LLM會先讀取提示詞,這一步因為平行處理而很快,接著再逐一寫出回答的每個token。在測試中最快的手機上,也就是執行MNN的Snapdragon 8 Elite等級手機,Qwen3.5-9B讀取提示詞的速度最高達每秒85.2個token,寫出回答的速度則為每秒9.3個token。
同一系列的較小模型則快得多,因為手機的速度取決於它們在記憶體中搬移權重的快慢。下方動畫以各模型測得的最快寫出速度,即時重播同一個回答的產生過程。
4B模型也能在8 GB手機上執行,因此符合條件的Processor多得多。0.8B模型讓記憶體大多處於閒置,所以一支手機可以同時服務多個對話:即使是一支8 GB手機,也能同時服務四個平行對話,合計每秒46個token。
成本是多少
部署會以ACU(網路的功能型代幣)設定最高價格,再由Matcher將它與符合需求的手機配對。對於記憶體12 GB以上的手機,測試當天的市場平均價格為每支手機每天0.57 ACU,出價1.03 ACU即可立即完成配對。以當時來說,大約是5到10美分。整個研究共約60次手機執行,花費約14 ACU。
同時處理大量請求
一項規模更大的測試租用了超過100支手機,並以一段真實、長達7,000個token的提示詞計時,這正是Coinbase審查員所讀取的長度。最快的是一支搭載Snapdragon 8 Elite等級晶片的16 GB手機,執行的是Qwen開發商Alibaba推出的開源引擎MNN。它讀完這段提示詞,9B模型需要3分15秒,4B需要1分37秒,0.8B只需15秒。
單支手機讀取7,000個token提示詞所需時間
Qwen3.5-9B
3分15秒
Qwen3.5-4B
1分37秒
Qwen3.5-0.8B
15秒
使用一段真實的7,000個token提示詞測量,測試對象為100支手機測試中最快的一支(16 GB,Snapdragon 8 Elite等級晶片),MNN引擎,8個CPU執行緒,4位元模型。
這些時間是一支手機處理一個請求的數字。每支手機各自處理自己的請求,因此十個副本能同時讀取十段提示詞,一百個副本就能同時讀取一百段。對審查佇列或夜間批次作業來說,真正重要的是每小時能完成多少工作,而這個數字會隨著每增加一支手機而成長。
架設在手機上的專精模型適合哪些情境
大多數專精工作都在佇列與背景中執行,在這些情境下,吞吐量與可用性比單一回答的速度更重要:
- 複審佇列:退單爭議、遭標記的帳戶與客服工單,能在一分鐘內得到初步判定,不必花上數小時等待人工處理。
- 全天候守衛:社群聊天室的詐騙過濾器,以及AI代理前方的提示詞注入檢查,幾秒內就能讀完簡短訊息。
- 批次評分:在夜間重新檢查前一天的交易,並分散到工作所需數量的手機上。
Laya示範展現了其中短輸入的一端:一支手機上的分類器,能在0.2到1秒內分類詐騙訊息。
網路帶來的優勢:隱私、規模與可用性
隱私。提示詞會傳送到您自己的部署,而不是模型供應商,這正是Coinbase選擇自架的理由。根據Acurast文件,智慧型手機的可信執行環境(TEEs)能「確認硬體是真實而非偽造的,並在無需信任手機持有者的情況下維持機密性」。API金鑰等機密資訊以加密環境變數的形式傳送,「只有在程式碼於Processor上執行時才會解密」。
規模。一份設定檔執行了十支手機,每支都有自己固定的HTTPS位址;一項規模更大的測試則在一個下午內租用了超過100支手機。增加容量只需要提高副本數量:有137支手機符合0.8B模型的需求,因此同一份設定檔設為100個副本,以現有的手機數量就足以支應。
可用性。分散在各地手機上的部署,不存在會整個停擺的單一資料中心。每當有手機忙碌或離線時,備用副本會讓佇列持續運轉,而同一份設定檔也能隨時重新部署到新的手機上。
執行您自己的模型
本文背後的程式碼是公開的。Acurast範例應用程式中的Qwen範例會在手機上執行Qwen3.5,並透過相容OpenAI的API提供服務,而且不需建置步驟,就能直接在Acurast Hub Playground中開啟。第二個範例LLM on MNN以MNN引擎提供相同的API,本文最快的成績正是出自這個引擎,它同樣收錄在Playground中。Acurast文件中的LLM指南說明如何在部署中載入模型,Acurast Tunnel快速入門則介紹公開的HTTPS位址。如果您像Coinbase一樣進行微調,請在轉換模型之前,先將LoRA權重合併到模型中:這樣得到的模型,大小與速度都和基礎模型相同。
正在Acurast上開發嗎?如果您正在訓練自己的專精模型,並希望在經認證的手機上提供服務,歡迎到Acurast Discord交流心得。